AI により変数の構成比率を可視化させてデータの構造を確認します
Copyright © 2026GotoAI株式会社gooseプロジェクトに基く
本事例の手順は、以下の環境で動作を確認しています。
- Kari: バージョン 0.7.3 Windows
- AI プロバイダー: OpenAI ChatGPT サブスクリプション
- モデル: GPT-6.1 Sol High
説明
前のページで、生の CSV は 207,636行・28列 のテーブルになり、各列に型が付きました。しかし、どの列に何がどれだけ入っているかは、つまりデータの構造はまだ分かっていません。
分析に入る前に確認しておきたいのは、次のような点です。
- 値が1種類しかなく、分析に使えない列はどれか
- 中身が重複していて、どちらか一方で足りる列はどれか
- Null が大きな割合を占める列はどれか
- 連続数値の列は、どのあたりに値が偏っているか
これを調べるには、28列を1列ずつ集計し、分布を見ていくことになります。カテゴリの列は値ごとの件数を数え、数値の列は区切りを決めて階級に分ける必要があり、手作業では相応の時間がかかります。
Kari の 「データフロー」 を使えば、この集計を AI に一括で任せられます。データフローは、テーブルを入力として新しい集計結果を作る処理の単位です。元のテーブルは変更されません。 集計結果はそのままチャートにでき、処理の内容は Python スクリプトとして残ります。
作業の準備
-
前のページで作成した「データコレクション1:不動産価格.csv:テーブル1」が、データコレクションに登録されていることを確認します。
-
チャットセッションを開きます。データフローの作成は、左のツリーからの操作ではなく、チャットでの指示から始めます。
AI に作業を指示
- 対象のテーブル、保存するデータフローの名前、そして集計の規則をまとめて、以下のように AI に作業を指示します。
データテーブル「データコレクション1:不動産価格.csv:テーブル1」をもとに、下記の分析を実施し、結果をデータフロー「不動産データ各変数構成」として保存し、指示に応じてチャートを作成する。

1. 各カラムの件数構成比率を集計し、積み上げ棒グラフで表示する。
2. カテゴリ変数の場合、値のままで区分値として使う。ただし、カテゴリレベル種類が30以上の場合、頻度の順で30位以下のものを一つの区分まとめる。
3. 連続数値変数の場合、分布により、5区分の程度で適宜に区切りを定義して集計する。
4. Null値があった場合、Nullを一つの区分として定義する。
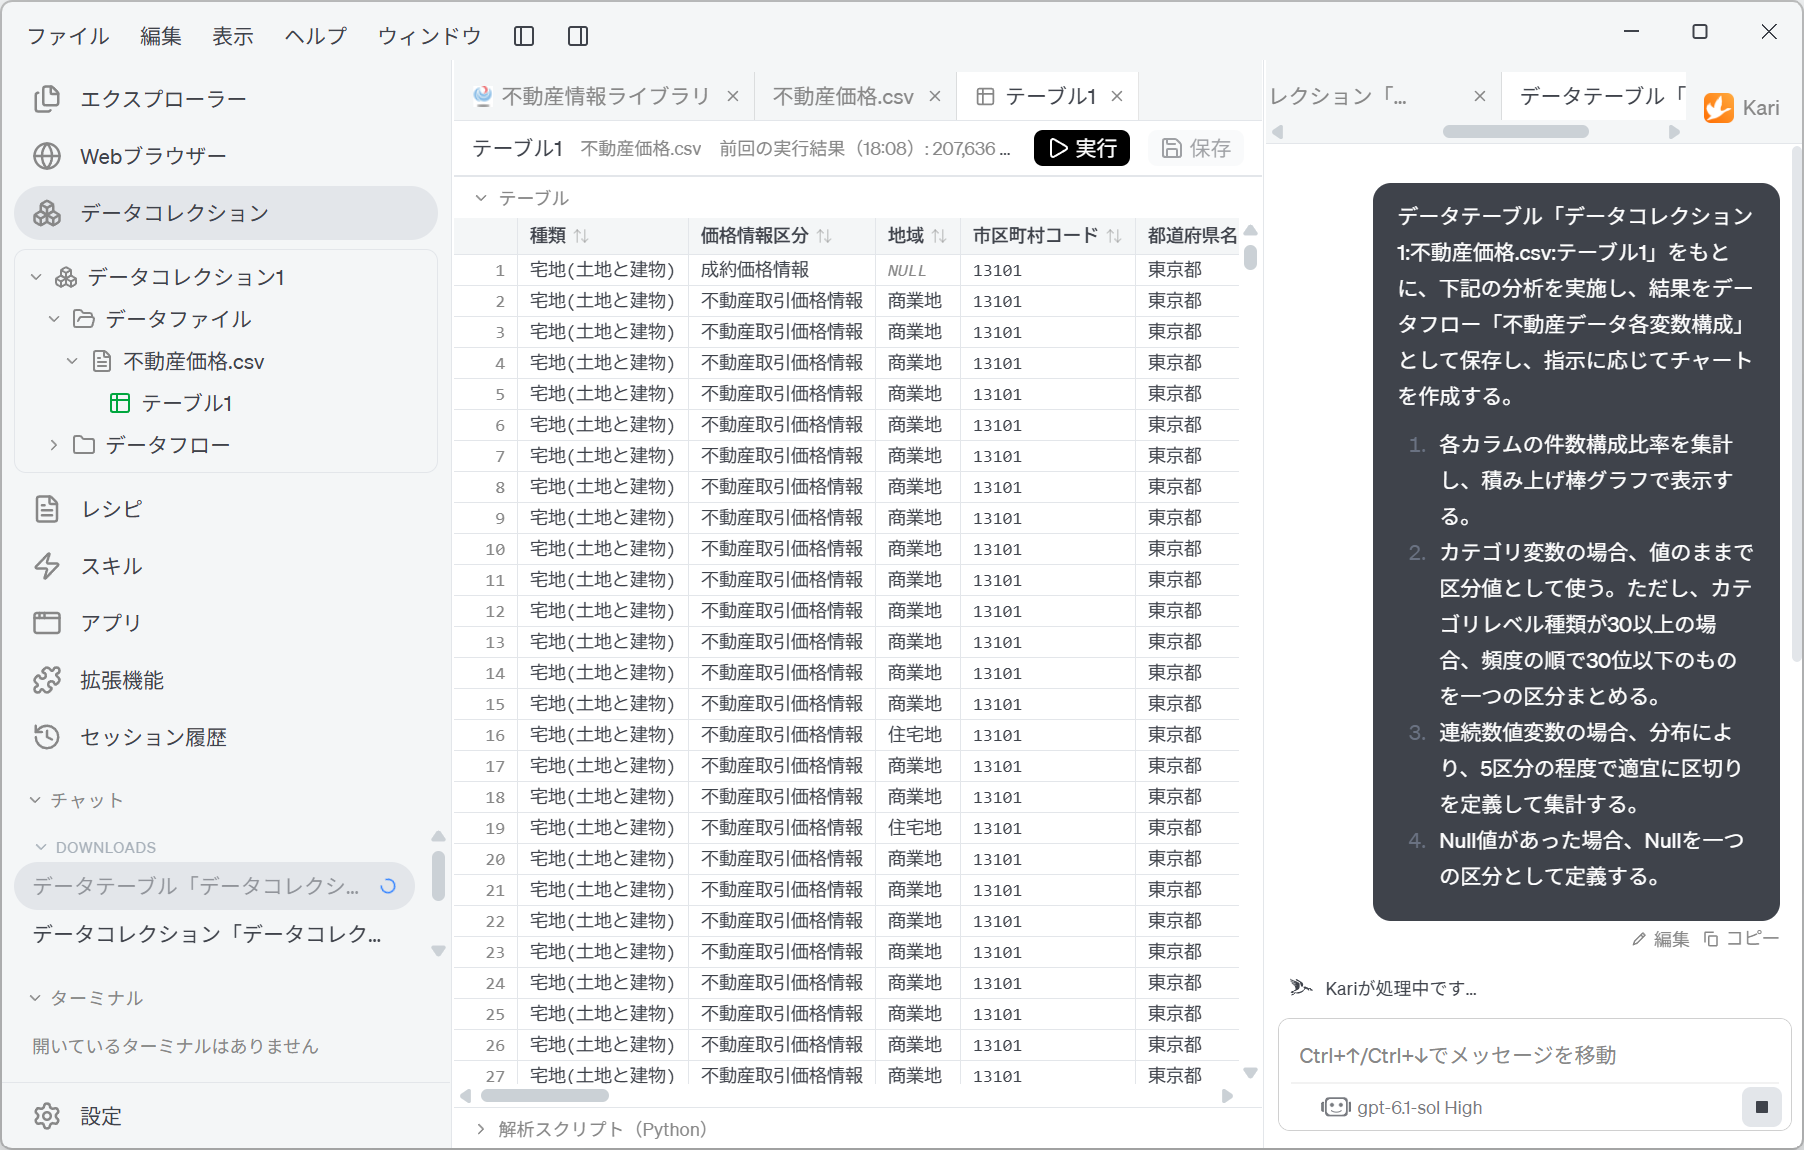
この指示の組み立て方には、次のポイントがあります。
| 指示のブロック | ねらい |
|---|---|
| 対象テーブルの指定 | コレクション名:ファイル名:テーブル名の形で、入力を一意に特定します。データファイルが複数ある場合に取り違えを防げます。 |
| データフロー名の指定 | 集計結果に名前を与えて保存させます。名前を指定しないと、何を集計したものか後から分からなくなります。 |
| 1. 集計とグラフの形 | 「件数構成比率」と「積み上げ棒グラフ」を指定します。列ごとに縦軸の単位が違うと1枚に並べられないため、構成比に揃えることが前提になります。 |
| 2. カテゴリの上限 | 区分が多すぎるとグラフが読めなくなります。30種類という上限と、超えた場合の扱い(頻度の低いものをまとめる)をあらかじめ決めておきます。 |
| 3. 数値の区切り | 「分布により」「適宜に」と幅を持たせ、区切りの決定を AI に委ねています。 代わりに「5区分程度」という粒度だけを固定します。 |
| 4. Null の扱い | この事例で重要な指定です。 Null を除外して集計すると、欠損の多い列が「きれいな列」に見えてしまいます。Null を1つの区分として数えさせることで、欠損がグラフ上に現れます。 |
構成比のグラフでは、Null をどう扱うかで見え方が大きく変わります。 指示に書かなければ、Null は除外されたり、空欄として落とされたりします。欠損の状況を知ることが目的であれば、必ず明示してください。
AI の作業結果を確認
- AI が集計スクリプトを書いて実行し、結果を報告します。左のツリーの「データフロー」の下に 「不動産データ各変数構成」 が現れます。
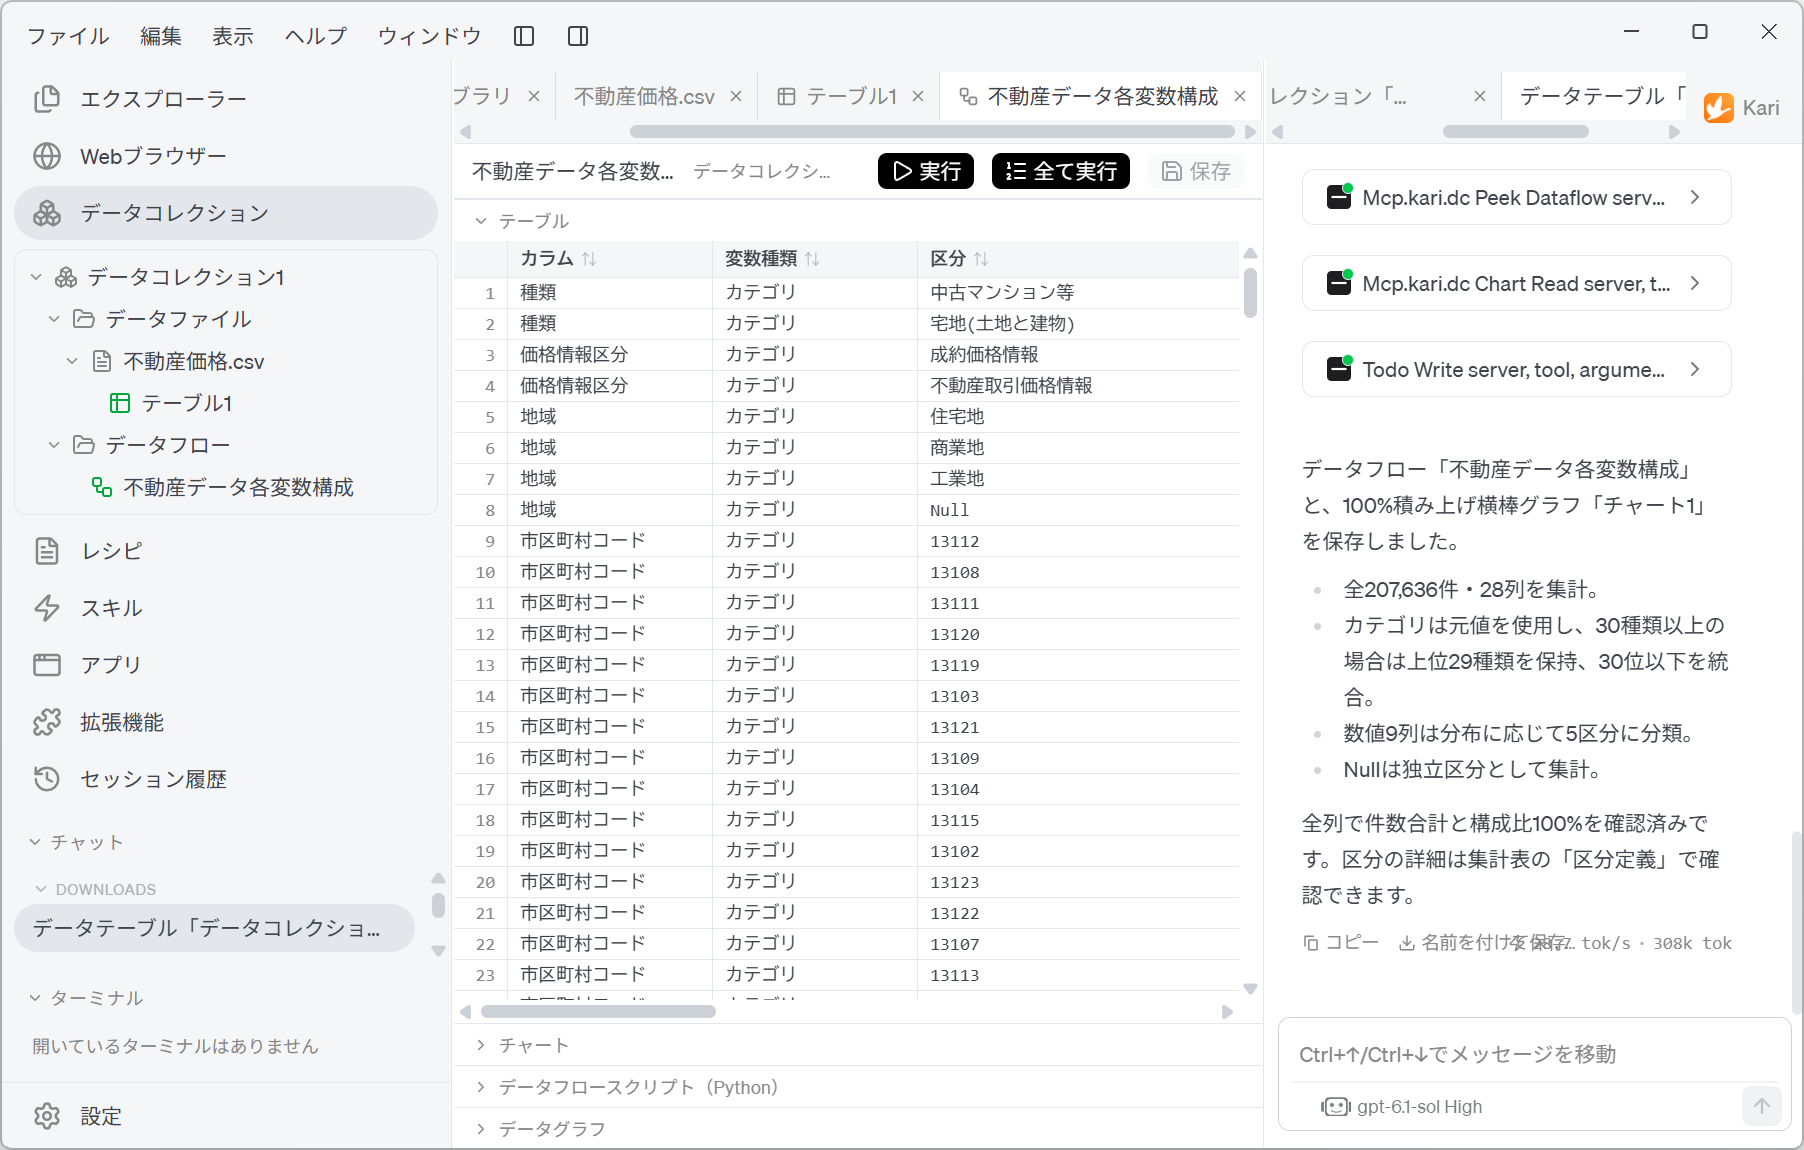
この例では、次のことが報告されています。
- データフロー「不動産データ各変数構成」と、100%積み上げ横棒グラフ「チャート1」を保存した。
- 全 207,636件・28列 を集計した。
- カテゴリは元の値を使用し、30種類以上の場合は上位29種類を保持して30位以下を統合した。
- 数値 9列は、分布に応じて5区分に分類した。
- Null は独立した区分として集計した。
- 全列で件数合計と構成比100%を確認済み。
指示では「30位以下のものを一つの区分まとめる」と書きました。AI の報告は「上位29種類を保持、30位以下を統合」です。つまり、保持した29種類+統合した1区分で、合計30区分に収まっています。指示の文面は「30位以下をまとめて31区分」とも読めるため、AI がどちらの解釈を採ったかは、報告を読んで確かめる必要があります。
- 「テーブル」には、集計結果が 341行で出力されます。「カラム」「変数種類」「区分」「件数」「構成比」「総件数」「カラム順」の列で、どの列がどの区分に分かれ、それぞれ何件あったかを1行ずつ追えます。
| カラム | 変数種類 | 区分 | 件数 | 構成比 | 総件数 |
|---|---|---|---|---|---|
| 種類 | カテゴリ | 中古マンション等 | 158,712 | 0.7643761197480206 | 207,636 |
| 種類 | カテゴリ | 宅地(土地と建物) | 207,636 | ||
| 価格情報区分 | カテゴリ | 成約価格情報 | 207,636 | ||
| 価格情報区分 | カテゴリ | 不動産取引価格情報 | 207,636 | ||
| 地域 | カテゴリ | 住宅地 | 207,636 | ||
| 地域 | カテゴリ | 商業地 | 207,636 | ||
| 地域 | カテゴリ | 工業地 | 207,636 | ||
| 地域 | カテゴリ | Null | 207,636 |
-
「構成比」は
0.7643761197480206のように丸めずに保持されます。 グラフのラベルは読みやすく丸められるため、資料に数値を引用する場合は、この集計表から取ってください。 -
「総件数」の列が全行で 207,636 になっていることにも注目してください。どの列の集計でも母数が元のテーブルと同じであり、特定の列だけ対象が絞られていないことが、この列で確認できます。
-
「地域」に Null の行があることにも注目してください。指示の 4. が効いており、欠損が1つの区分として集計されています。
チャートで構造を把握する
- 「チャート」を開くと、100%積み上げ横棒グラフが1枚で表示されます。28列すべてが縦に並び、各行の内訳が区分ごとの帯になります。
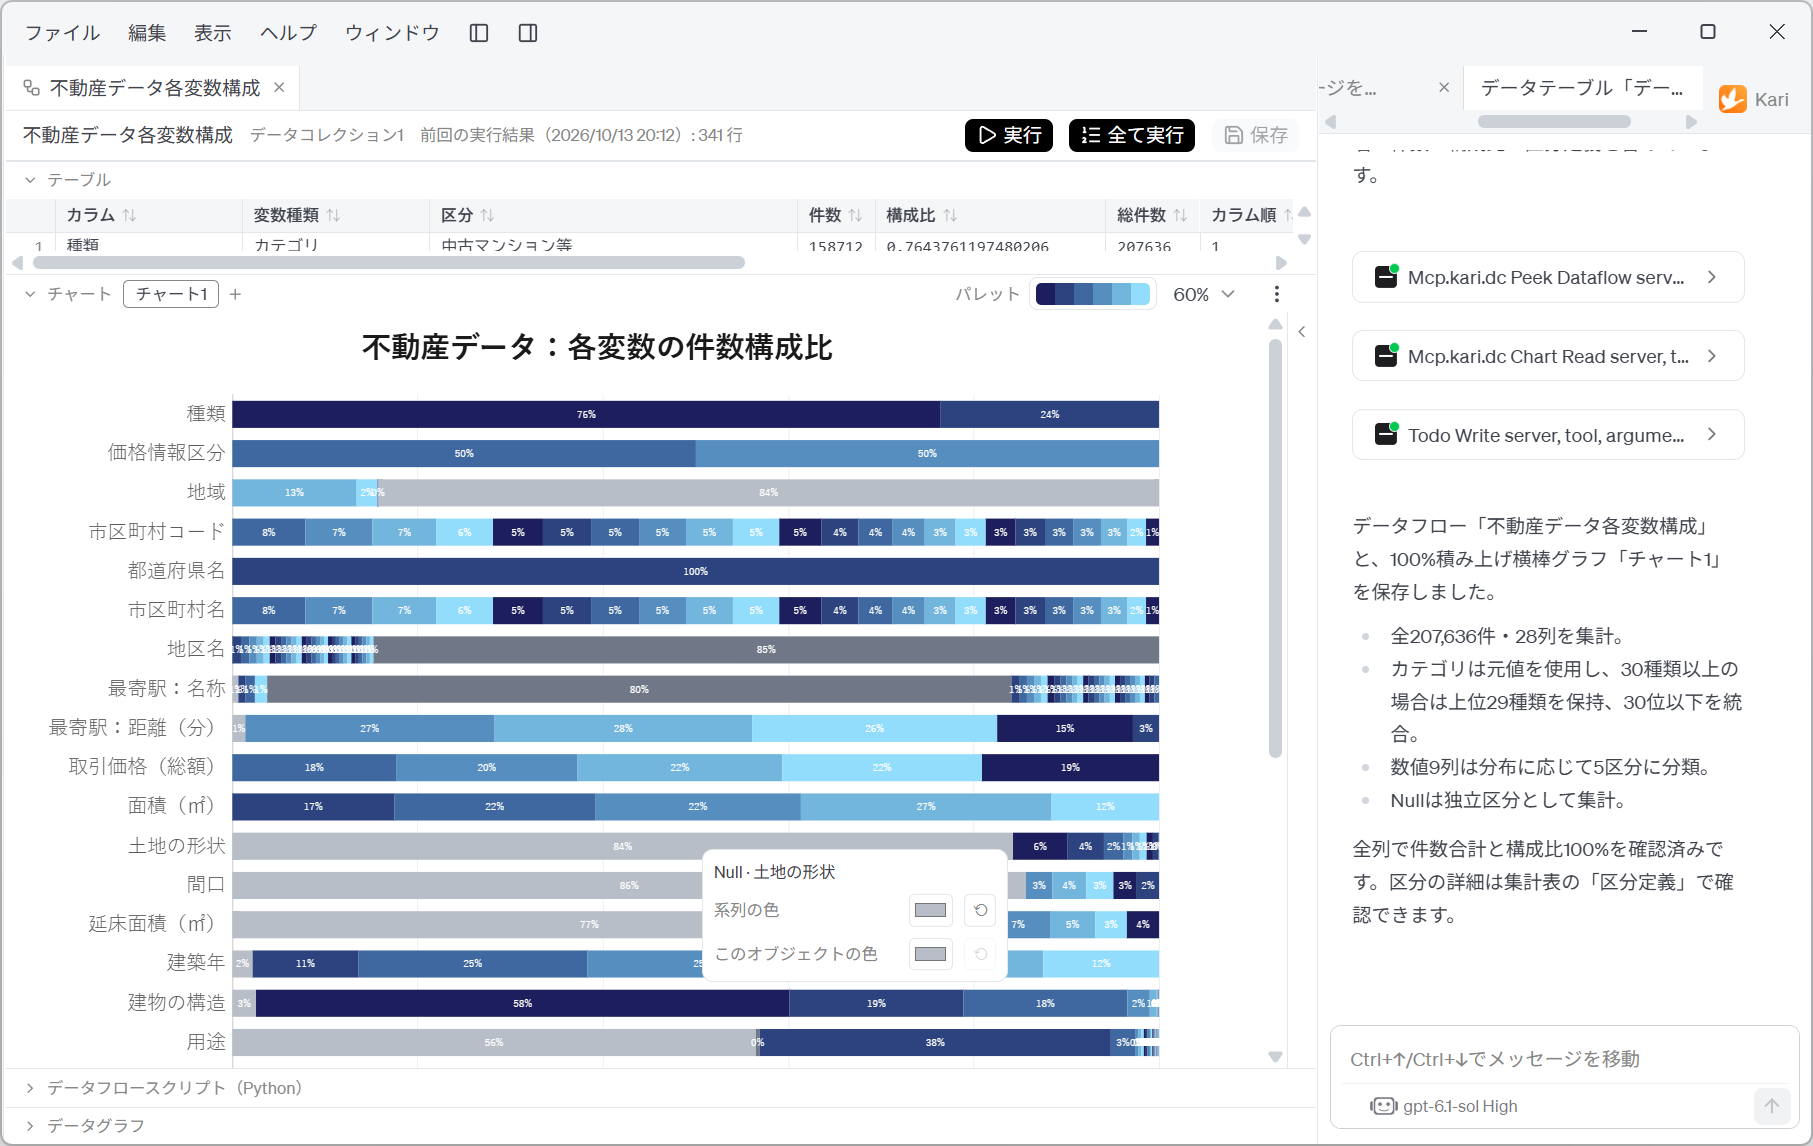
各帯には構成比が表示されます。1行が必ず100%になるため、列ごとに件数の桁が違っても、同じ尺度で並べて比較できます。
このグラフ1枚から、次のことが読み取れます。
| 読み取れること | グラフ上の見え方 | 分析への影響 |
|---|---|---|
| 「都道府県名」は値が1種類しかない | 帯が分かれず、100% の1本になる | 東京都のデータだけを取得したため当然ですが、この列は分析に使えません。 比較の軸にも、相関の変数にもなりません。 |
| 「市区町村コード」と「市区町村名」は同じ構造 | 2行の帯の並びが完全に一致する(8%・7%・7%・6%・5%…) | 同じ情報の別表現です。どちらか一方を使えば足ります。両方を変数に入れると、相関分析では重複して効きます。 |
| 「種類」は中古マンション等に偏っている | 76% と 24% の2区分 | 母集団の4分の3が中古マンション等です。全体の傾向は、ほぼ中古マンションの傾向になります。種類別に分けた分析が必要かを判断してください。 |
| 「価格情報区分」はほぼ半々 | 50% と 50% | 成約価格情報と不動産取引価格情報が同程度含まれています。出所の異なる価格が混在しているため、両者を区別せずに平均を取ってよいかの判断が必要です。 |
| 欠損が大半を占める列がある | 灰色の帯が大きく広がる(地域 84%、土地の形状 84%、間口 86%、延床面積(㎡)77%) | これらの列は、一部のレコードにしか値が入っていません。 条件や変数に使うと、対象が大きく絞られます。 |
| 「地区名」「最寄駅:名称」は区分が非常に多い | 細い帯が多数並び、加えて 85%/80% の大きな帯が1本ある | 30区分の上限に達した列です。大きな1本は、頻度の低い値をまとめた区分か Null のいずれかです。どちらであるかはグラフからは判別できないため、集計表で確認してください(下記「Human-in-the-loop のポイント」)。 |
| 連続数値の列は5区分にほぼ均等に分かれている | 取引価格(総額)が 18%・20%・22%・22%・19%、面積(㎡)が 17%・22%・22%・27%・12% | 分位点で区切られたことを示します。値の大小ではなく、順位による区切りである点に注意してください。 |
この種のグラフの目的は、値を読むことではなく、構造を見つけることです。「使えない列」「重複した列」「欠損の多い列」を分析の前に特定できれば、以降の仮説検証で無駄な試行を減らせます。個々の数値が必要になったら、「テーブル」の集計表を参照してください。
スクリプトとデータの流れを確認する
- 「データフロースクリプト(Python)」を開くと、AI が書いた集計スクリプトがそのまま読めます。
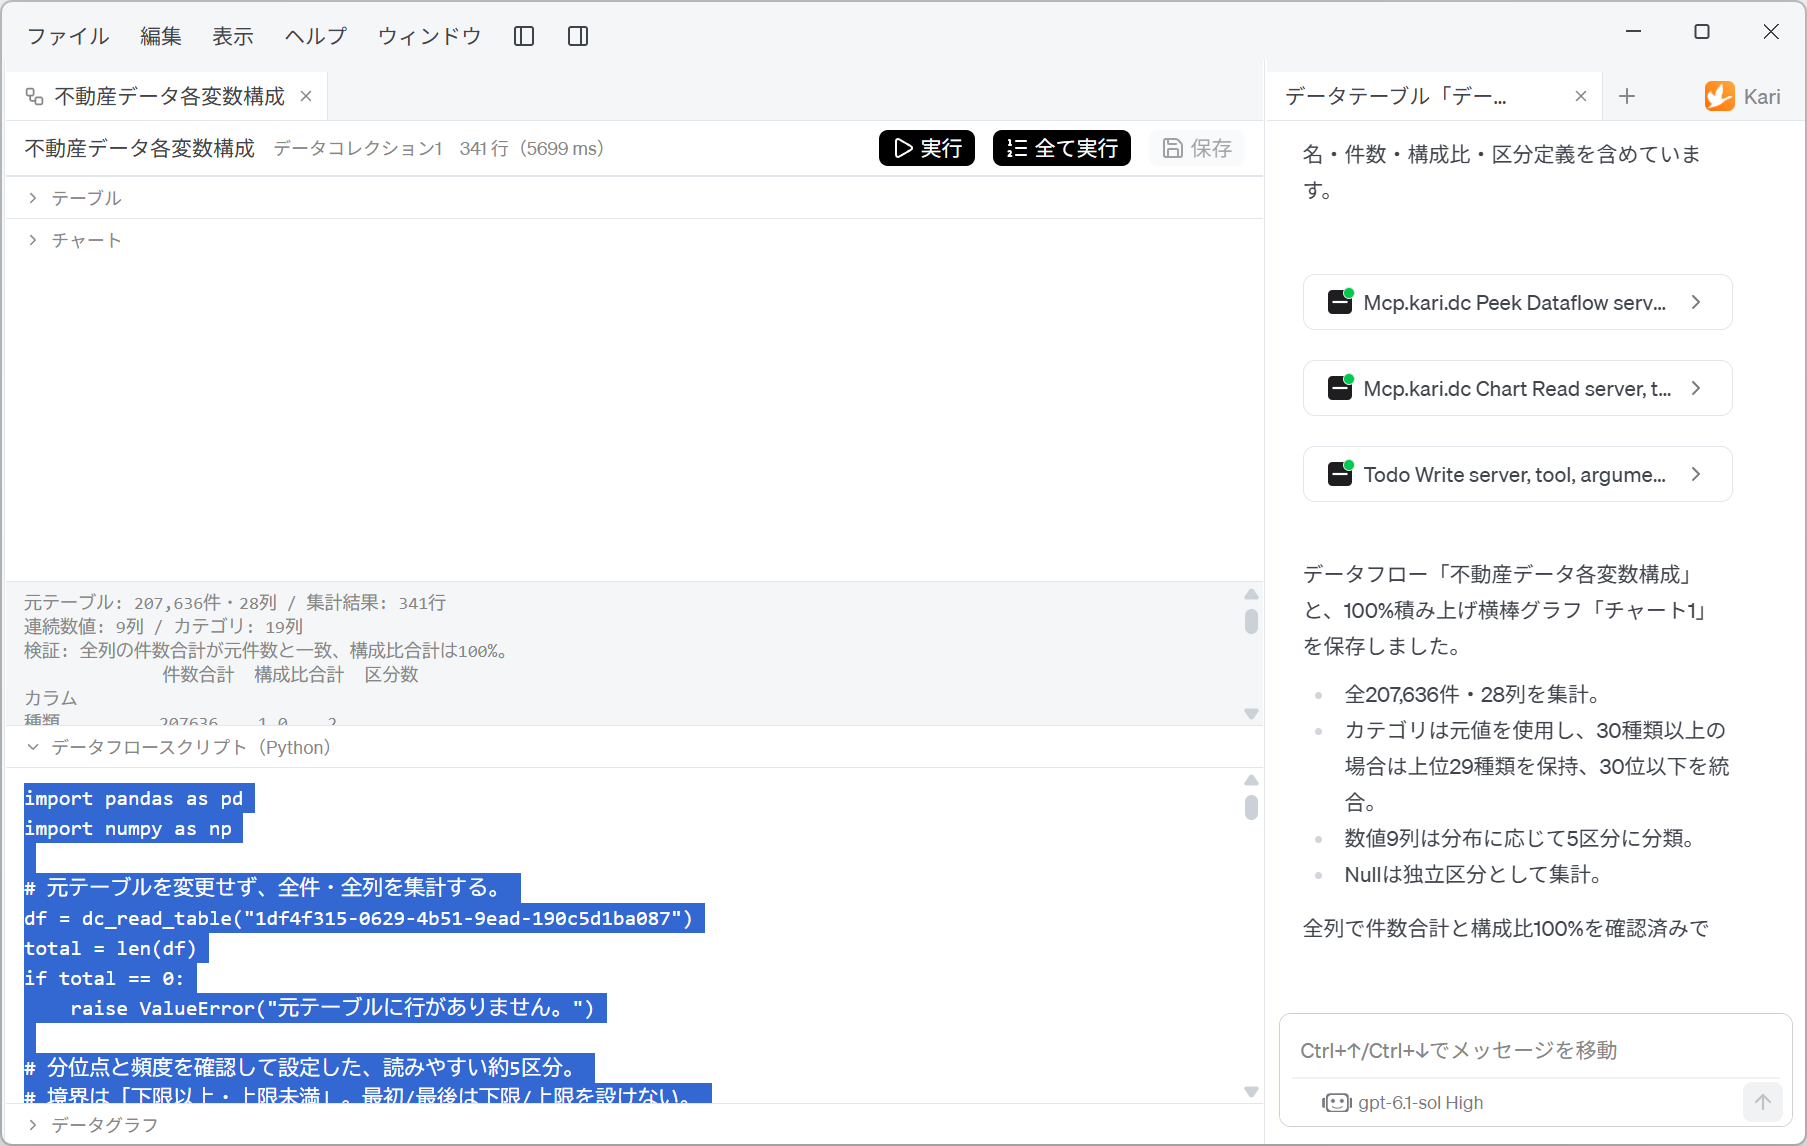
スクリプトの上の領域には、集計の検証結果が表示されます。
元テーブル:207,636件・28列  /  集計結果:341行
連続数値:9列  /  カテゴリ:19列
検証:全列の件数合計が元件数と一致、構成比合計は100%。
続けて「カラム」「件数合計」「構成比合計」「区分数」の表が出力され、列ごとに検証結果を確かめられます。「種類」は 件数合計 207636・構成比合計 1.0・区分数 2 です。元の件数が保たれ、構成比が過不足なく100%になっていることを、列ごとにここで確認できます。
import pandas as pd
import numpy as np

# 元テーブルを変更せず、全件・全列を集計する。
df = dc_read_table("1df4f315-0629-4b51-9ead-190c5d1ba087")
total = len(df)
if total == 0:
    raise ValueError("元テーブルに行がありません。")

# 分位点と頻度を確認して設定した、読みやすい約5区分。
# 境界は「下限以上・上限未満」。最初/最後は下限/上限を設けない。
冒頭のコメントに 「元テーブルを変更せず」 と明記されています。データフローは元のテーブルを読み取るだけで、書き換えません。集計のやり直しや条件の変更を、元データを壊す心配なく繰り返せます。
区切りについても、**「分位点と頻度を確認して設定した」「境界は下限以上・上限未満」**とコメントが残されています。区切りの根拠と境界の扱いがコードに書かれているため、その判断が妥当かどうかを人が検証できます。
- 「データグラフ」を開くと、データの流れが図で表示されます。
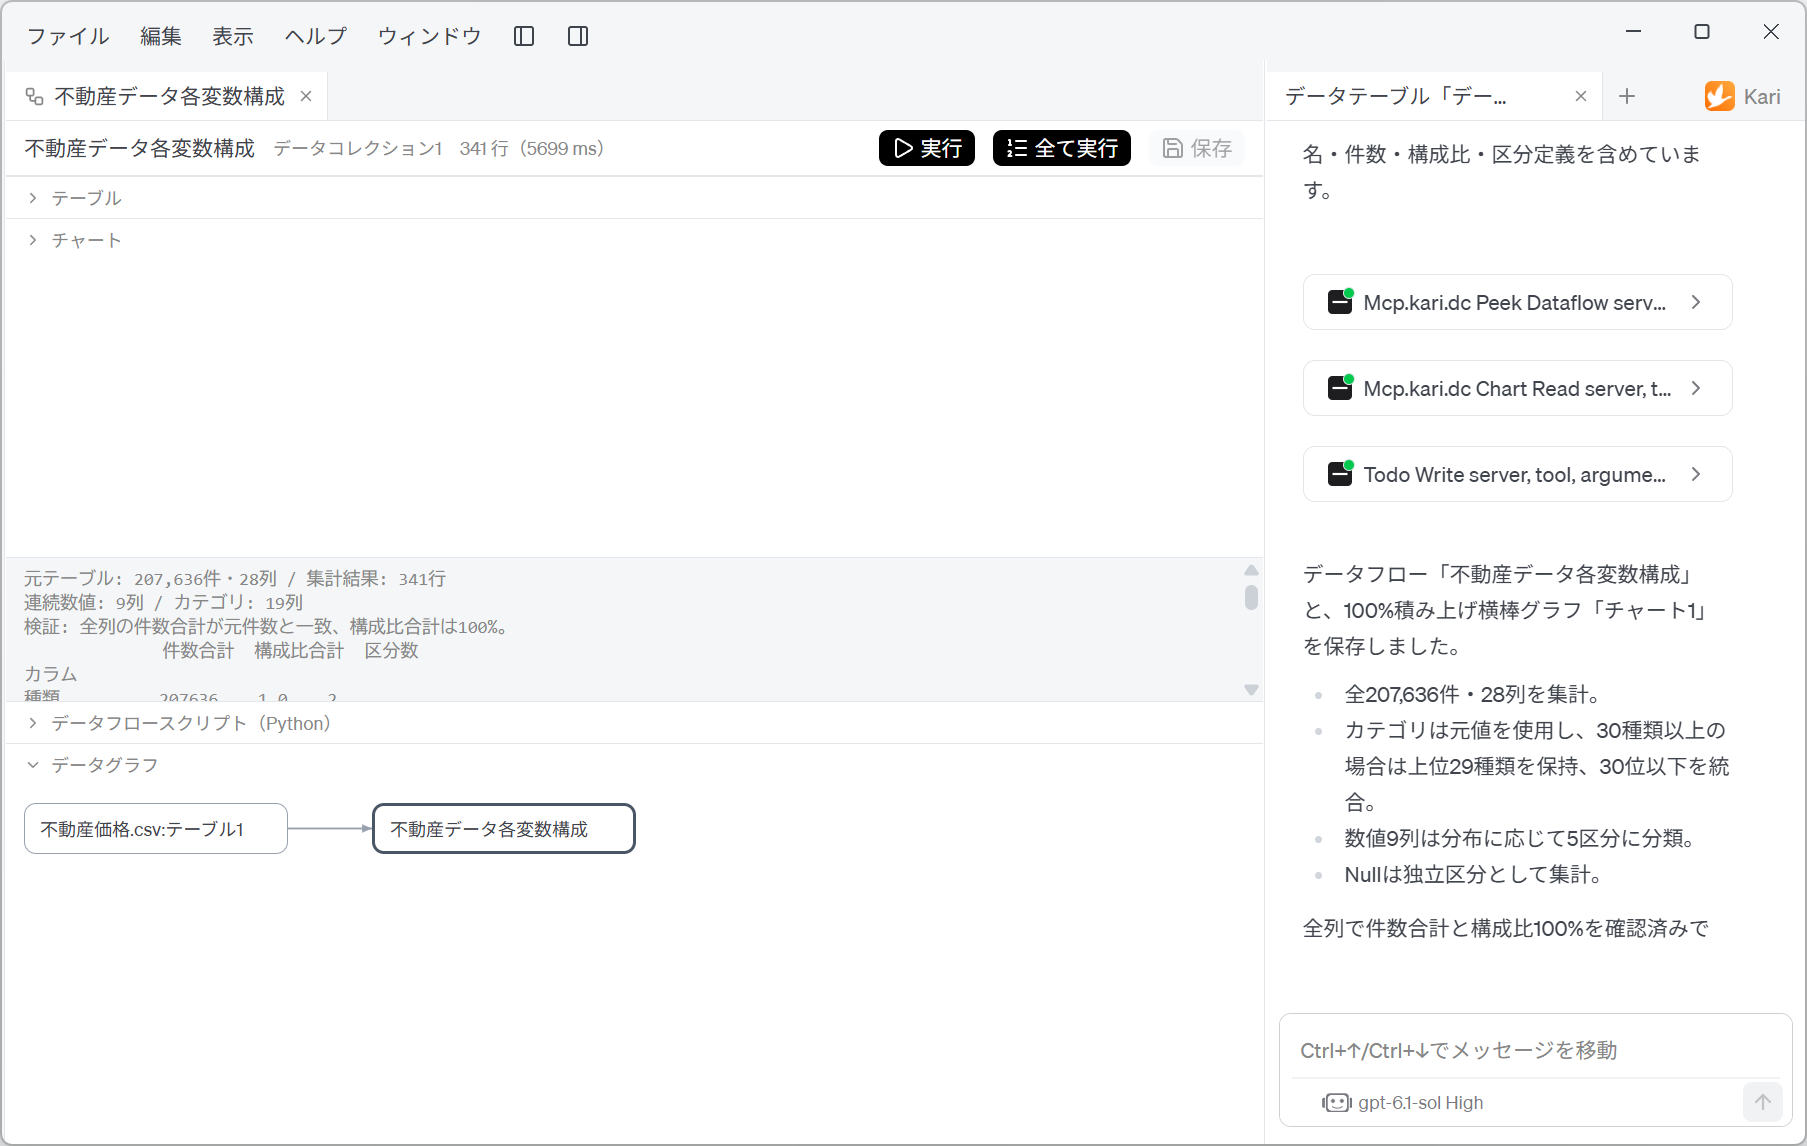
不動産価格.csv:テーブル1 から 不動産データ各変数構成 への1本の矢印が描かれます。どのテーブルから何が作られたかが図で追えるため、データフローが増えても、集計結果の出どころを見失いません。
Human-in-the-loop のポイント
AI に任せきりにせず、次の点は人が確認してください。
-
元件数との一致を確認する
集計で件数が増減していれば、集計そのものが誤っています。本例では「全列の件数合計が元件数と一致、構成比合計は100%」と検証結果が表示され、元テーブルの 207,636件と一致しています。この表示を、まず確認してください。 -
大きな帯が「欠損」なのか「統合された区分」なのかを見分ける
グラフ上で大きな面積を占める帯には、Null の区分と、頻度の低い値をまとめた区分の2種類があります。見た目が似ているため、グラフだけでは区別できません。「地区名」の85%、「最寄駅:名称」の80%のような帯は、集計表の「区分」の値を見て、どちらであるかを必ず確認してください。前者なら欠損の問題、後者なら区分設計の問題であり、対処がまったく異なります。 -
「その他」に統合された区分の中身を確認する
区分が30を超えた列では、頻度の低い値がまとめられています。 「地区名」「最寄駅:名称」のような列では、まとめられた側に分析対象が含まれている可能性があります。統合された区分を使って判断する前に、集計表の「区分定義」で中身を確認してください。 -
数値の区切りの根拠を確認する
5区分の境界は、AI が分布を見て決めたものです。業務上の意味(たとえば「5,000万円以上」のような実務的な区切り)とは一致しません。資料に使う場合は、スクリプトの境界値を読み、必要なら書き換えて再実行してください。 -
Null の意味を切り分ける
Null には「元データで記録されていない」場合と「その物件には該当しない」場合があります。本例の「地域」「間口」「延床面積(㎡)」のように欠損が大きい列は、どちらの Null なのかを元データの仕様に戻って確認してください。 両者を同じ欠損として扱うと、以降の分析を誤ります。 -
定数列と重複列を分析から外す
「都道府県名」のように値が1種類の列は、分析に寄与しません。「市区町村コード」と「市区町村名」のように内容が重複する列も、両方を使うと重複して効きます。このグラフは、それらを見つけるために描いています。 見つけた結果を、以降の分析の変数選択に反映してください。 -
資料に引用する数値は集計表から取る
グラフのラベルは読みやすさのために整数に丸められます(例:「種類」の 76%)。集計表には0.7643761197480206のように丸めない値が保持されています。資料に数値を引用する場合は、グラフからではなく「テーブル」の集計表から取ってください。 -
データフローは元テーブルを変更しないが、上書きはされる
同じ名前のデータフローに対して再度指示を出すと、集計の内容は置き換わります。スクリプトを手で調整した場合は、控えを取ってから指示してください。
使用する LLM により、区分の切り方やカテゴリの統合方法が変わることがあります。同じ指示でも、区切りの境界は実行のたびに変わり得ます。 複数回の結果を比較する場合は、同じスクリプトを再実行してください。
参考資料
本ページで集計しているデータは、前のページまでで取得・解析した国土交通省「不動産情報ライブラリ」のデータです。画面キャプチャは出所を明示した上で引用として掲載しています。AI が出力した集計・区分の定義・チャートおよびスクリプトは、GotoAI が Kari の動作例として生成したものであり、国土交通省が作成・公表したものではありません。
- 資料名: 不動産情報ライブラリ「不動産価格(取引価格・成約価格)情報の検索・ダウンロード」
- 提供元: 国土交通省
- URL: https://www.reinfolib.mlit.go.jp/realEstatePrices/
- 閲覧日: 2026年10月13日
- 利用条件: 同サイトの利用規約に従います。出典:国土交通省ウェブサイト(上記 URL)。
- 本サイトで引用した外部の情報は、Kari の利用例を説明するためのものです。それらの情報の正確性や最新性について、本サイトは保証しません。引用元の内容は予告なく変更・削除されることがあります。
- 本サイトで示した AI の出力は、記載の検証環境で実際に得られたものです。ただし、その出力の正確性や有用性について、本サイトは保証しません。AI の出力は、使用する LLM や設定、実行のたびに変わることがあります。
- 本ページに示した区分の定義・区切りの境界は、AI が元データの分布から決めたものであり、公的に定められた区分ではありません。
- AI が生成した集計スクリプトは、利用者ご自身の責任でご確認のうえお使いください。区分の定義を誤ったまま集計すると、結果は誤ったものになります。
- 画面キャプチャは、掲載時点のバージョンの Kari で取得したものです。お使いのバージョンでは表示が異なる場合があります。
- 本ページで扱うのは実際の不動産取引価格のデータです。購入や投資の判断に用いる場合は、必ず元データと照合してください。
- 引用元の各機関・団体は、本サイトおよび Kari と提携・推奨関係にはありません。