Kari の AI エージェントで、中古マンション等の単位面積価格と他の変数との相関を分析する
Copyright © 2026GotoAI株式会社gooseプロジェクトに基く
本事例の手順は、以下の環境で動作を確認しています。
- Kari: バージョン 0.7.3 Windows
- AI プロバイダー: OpenAI ChatGPT サブスクリプション
- モデル: GPT-6.1 Sol High
説明
前のページで、どの列に何がどれだけ入っているかが分かりました。次に知りたいのは、価格は何と一緒に動くのかです。
Y=取引価格(総額)÷面積(㎡)、つまり平方メートルあたりの単価を作り、これを分析の軸にします。そして対象は 「中古マンション等」に絞ります。 前のページで見たとおり母集団の4分の3が中古マンション等で、土地と建物(戸建て)とは価格の決まり方が違います。種類を混ぜたまま相関を見ると、変数との関係ではなく種類の違いを見てしまいます。
そのうえで、残り26個の変数それぞれについて Y との関係の強さを測ります。ここで問題になるのが、変数の型によって使う指標が違うことです。
| 変数の型 | 指標 | 範囲 | 符号 |
|---|---|---|---|
| 数値(築年数、駅距離など) | Pearson の r | −1〜1 | あり(+は増加、−は減少) |
| カテゴリ(市区町村名、間取りなど) | 相関比 η | 0〜1 | なし |
26変数を型で振り分け、指標を使い分け、順位を付け、さらに上位の変数については中身を見る——手作業では一日仕事です。この一連を、Kari のデータフローとして AI に一括で作らせます。
作業の準備
-
前のページで作成した「データコレクション1:不動産価格.csv:テーブル1」が、データコレクションに登録されていることを確認します。
-
チャットセッションを開きます。前のページと同様、データフローの作成はチャットでの指示から始めます。
AI に作業を指示
- 抽出条件、作成する変数の計算式、保存するデータフロー名をまとめて指示します。
データテーブル「データコレクション1:不動産価格.csv:テーブル1」をもとに、下記の分析を実施する。結果をデータフローとして保存し、指示に応じてチャートを作成する。

1. 種類="中古マンション等"のレコードを抽出し、以降の分析のインプットデータセットとする。
2. 新しい変数を作成し、データーフロー「中古マンション等単位面積価格」として保存する。
  (1) 変数Y=「平方メートルあたり不動産価格」を、「取引価格(総額) ÷ 面積(㎡)」の計算式で作成する。
  (2) 変数「築年数」 を、「現在の西暦年 - 建築年」の計算式で作成する。必要に応じて「建築年」を西暦年にあらかじめ変換する。
3. 取引価格(総額)、面積(㎡)、建築年、Y以外の変数と、Yの相関性を分析してデータフロー「中古マンション等単位面積価格相関分析」として保存する。なお、相関分析をできなかった場合、その理由をチャットで明示する。
4. 相関分析の結果に、カテゴリ変数と数値変数の区分フラグをいれ、それぞれの区分での相関性の順位を入れる。
5. カテゴリ変数と数値変数をもとにそれぞれ2つの縦棒グラフを作成し、相関性絶対値の降順で表示する。
6. カテゴリ変数で相関性の高い上位3つの変数を選び、それぞれの変数でY値を示す縦棒グラフを作成し、Y値の降順で表示する。相関性を示す指標値の説明をチャートのノートで表示する。
7. 連続数値変数で相関性の高い上位3つの変数を選び、それぞれの変数を横軸にし、Y値を縦軸にして散布図を作成する。相関性を示す指標値の説明をチャートのノートで表示する。
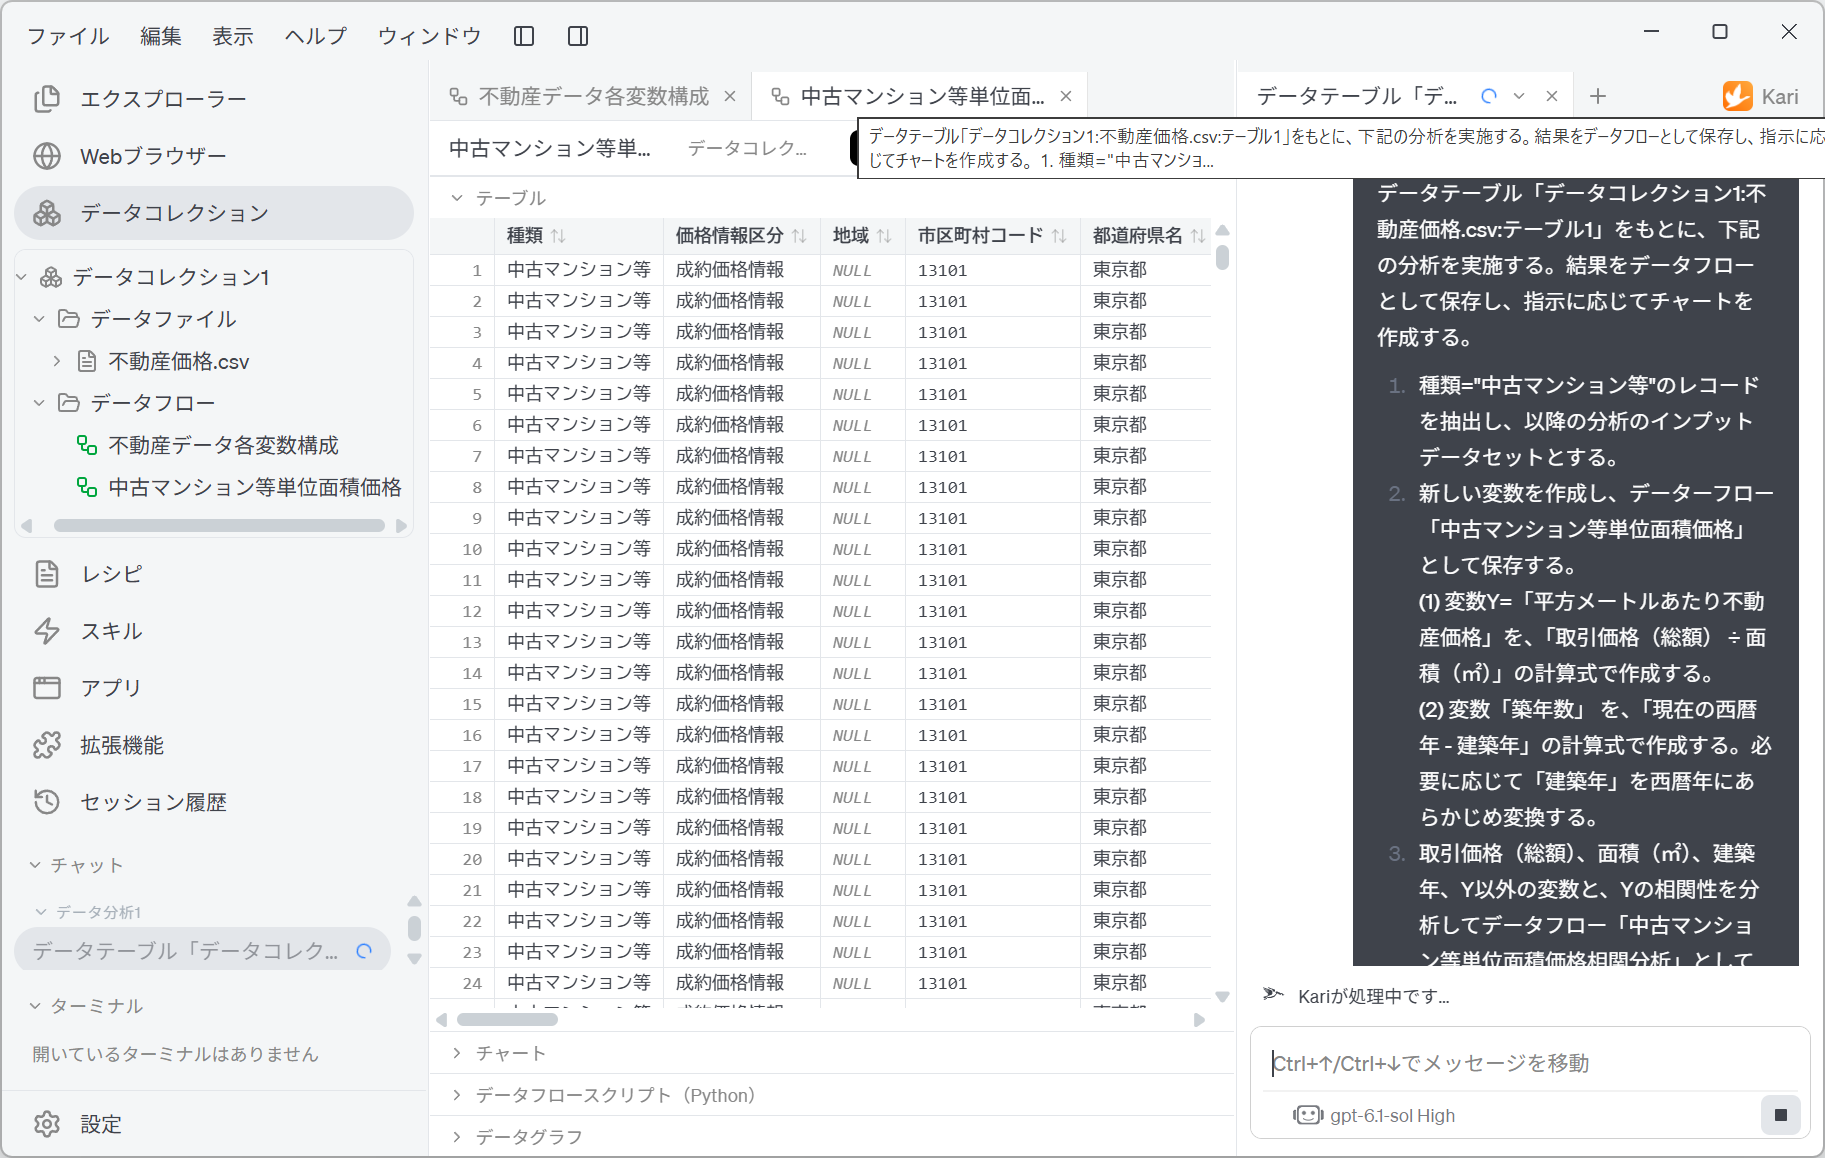
この指示の組み立て方には、次のポイントがあります。
| 指示のブロック | ねらい |
|---|---|
| 1. 種類での絞り込み | 分析の母集団を先に確定させます。 種類を混ぜたままでは、変数との相関ではなく種類の違いを測ってしまいます。 |
| 2-(1) Y の定義 | 計算式を言葉ではなく式で与えます。「単位面積価格」とだけ書くと、㎡あたりか坪あたりか、総額か㎡単価かが AI の解釈に委ねられます。 |
| 2-(2) 築年数の定義 | 「必要に応じて建築年を西暦年にあらかじめ変換する」と前処理まで指示に含めます。 建築年は 1990年 という文字列で、和暦の行も混じります。 |
| 3. 除外する変数の明示 | 理由の違う2種類を除外しています。 取引価格(総額)と面積(㎡)は Y の材料そのもので、除外しないと Y と強く相関するのは当然という結果が上位に並びます。建築年は 築年数と同じ情報(築年数=基準年−建築年)で、残すと順位表の上位を同じ情報が2つ占めます。 |
| 3. 分析できない場合の報告 | 「できなかった場合、その理由をチャットで明示する」と指示します。黙って落とさせないことが、後の確認作業を成立させます。 |
| 4. 区分フラグと区分内順位 | 型の違う指標(r と η)を1つの表に収めても順位が壊れないようにします。区分内順位があるので、数値とカテゴリを別々に読めます。 |
| 5. 区分ごとに2枚ずつ | 「それぞれ2つ」=計4枚です。絶対値で強さの順位を、符号付きで方向を見ます。同じ指標を2つの見方で出させています。 |
| 6-7. 上位3変数の深掘り | 順位表だけでは「効いている」しか分かりません。上位だけ中身を見ると限定することで、843水準すべてを描くような無駄を避けます。ノートに指標の説明を入れさせる指示も、ここに付けています。 |
| データフロー名の指定 | 中間結果に名前を与えて保存させます。後続の分析がこれを入力として参照できます。 |
Y の材料になった変数を除外する指示は、必ず入れてください。 取引価格(総額)を除外しないと、Y=価格÷面積である以上、変数の定義で価格との相関が上位に来ますが、これは本来知りたい現実の関係ではありません。
AI の作業結果を確認
- AI は抽出・変数作成・相関分析・チャート作成までを一度に実行し、結果を報告します。
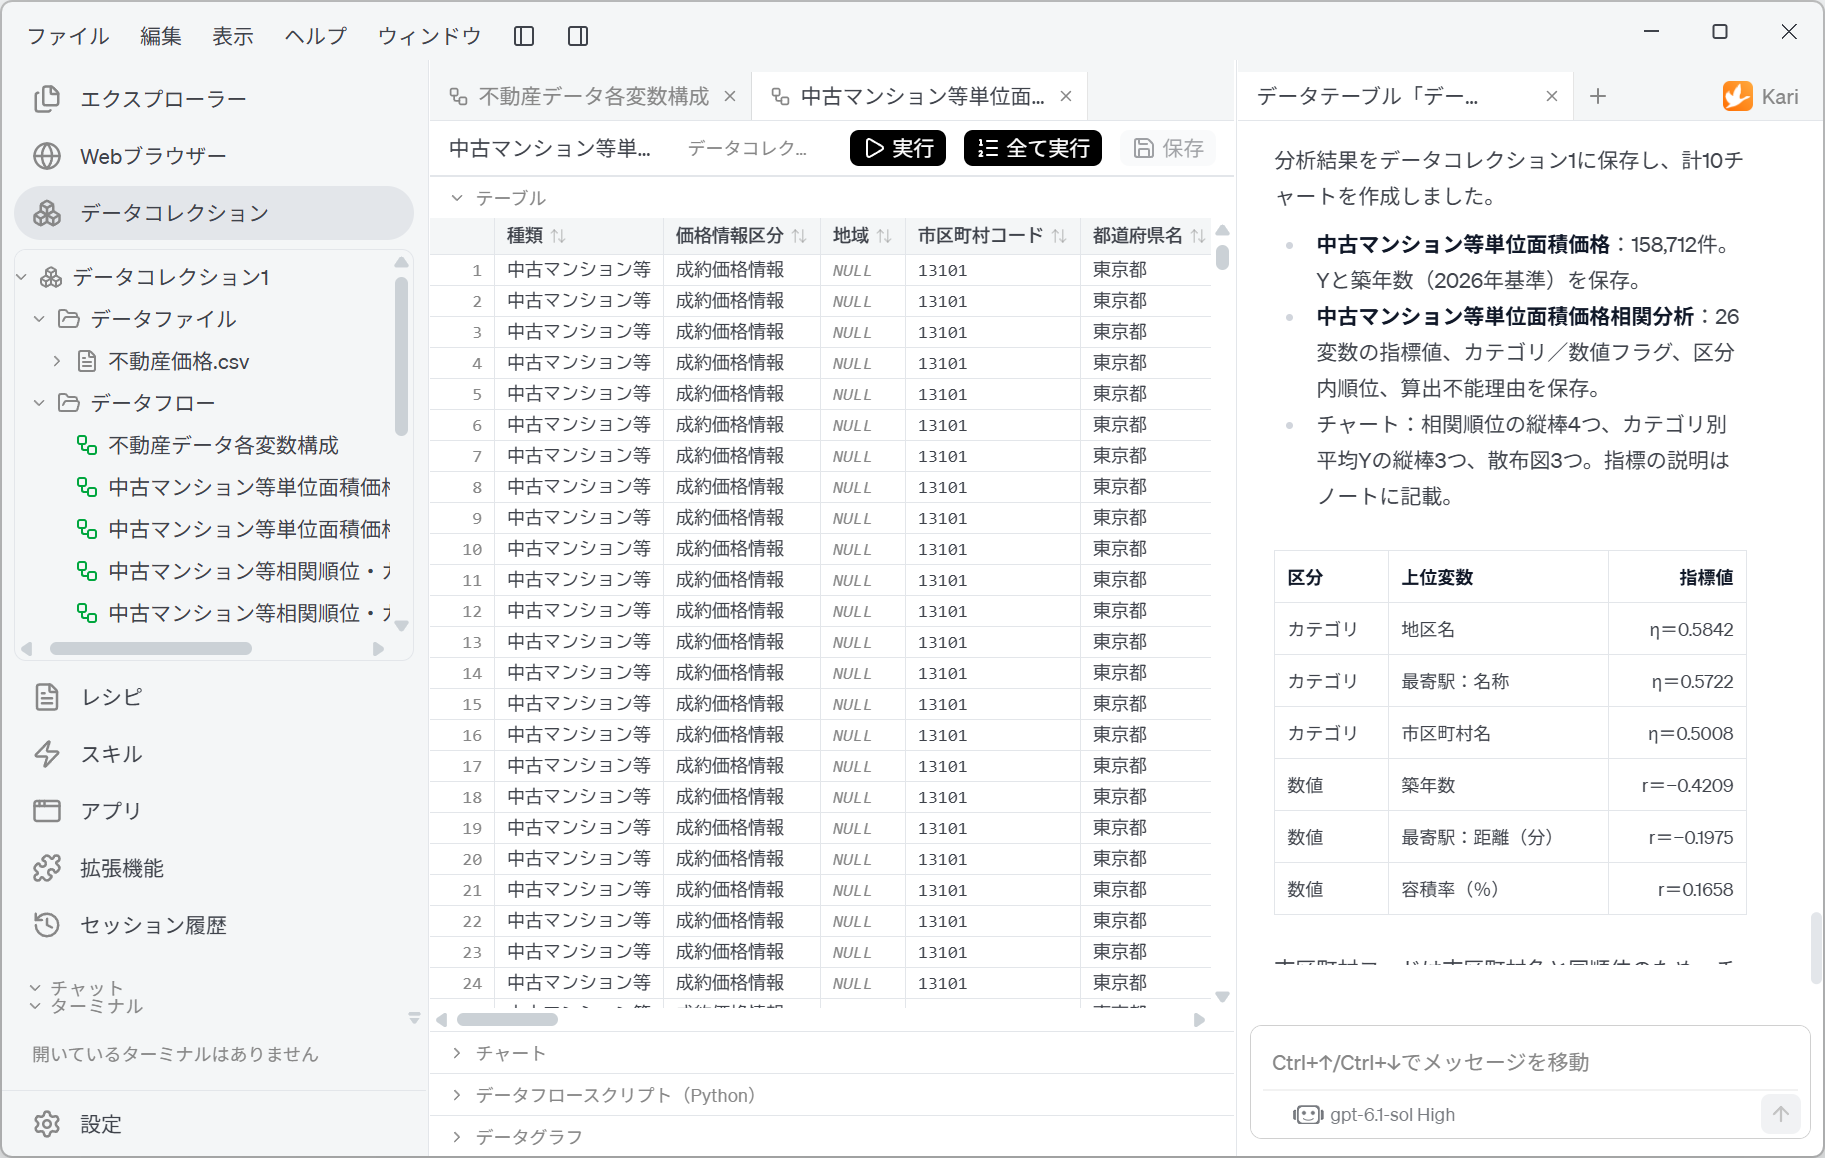
この例では、次のことが報告されています。
- 中古マンション等単位面積価格:158,712件。Y と築年数(2026年基準)を保存。
- 中古マンション等単位面積価格相関分析:26変数の指標値、カテゴリ/数値フラグ、区分内順位、算出不能理由を保存。
- チャート:相関順位の縦棒4つ、カテゴリ別平均Yの縦棒3つ、散布図3つの計10チャート。指標の説明はノートに記載。
| 区分 | 上位変数 | 指標値 |
|---|---|---|
| カテゴリ | 地区名 | η=0.5842 |
| カテゴリ | 最寄駅:名称 | η=0.5722 |
| カテゴリ | 市区町村名 | η=0.5008 |
| 数値 | 築年数 | r=−0.4209 |
| 数値 | 最寄駅:距離(分) | r=−0.1975 |
| 数値 | 容積率(%) | r=0.1658 |
-
報告の最後で、AI は自分の結果の読み方に注意を付けています。 「市区町村コードは市区町村名と同順位のため」——同じ区分を2つの列で持っているという指摘で、順位表を上から読むだけでは同じ情報を二度数えてしまう箇所です。なお、もう一組の重複だった建築年と築年数は、今回は指示の段階で建築年を除外したため、ここには現れていません。
-
さらに 分析できなかった変数が名指しで報告されます。この例では「地域、土地の形状、間口、延床面積、前面道路の方位・種類・幅員」。中古マンション等には土地や前面道路の情報がほとんど記録されないためで、欠落ではなくデータの性質です。
生成されたスクリプトは、分析できなかった変数に理由を書き込んでいます。「Yが有効な行で変数の有効値がない」「変数の値が1種類のみで分散がゼロ」「有効なペアが2件未満」——どの変数がなぜ落ちたかが、チャットの文章ではなくデータとして残ります。
相関の強い変数を順位で見る
- まず数値変数です。Pearson の r の絶対値で降順に並んでいます。
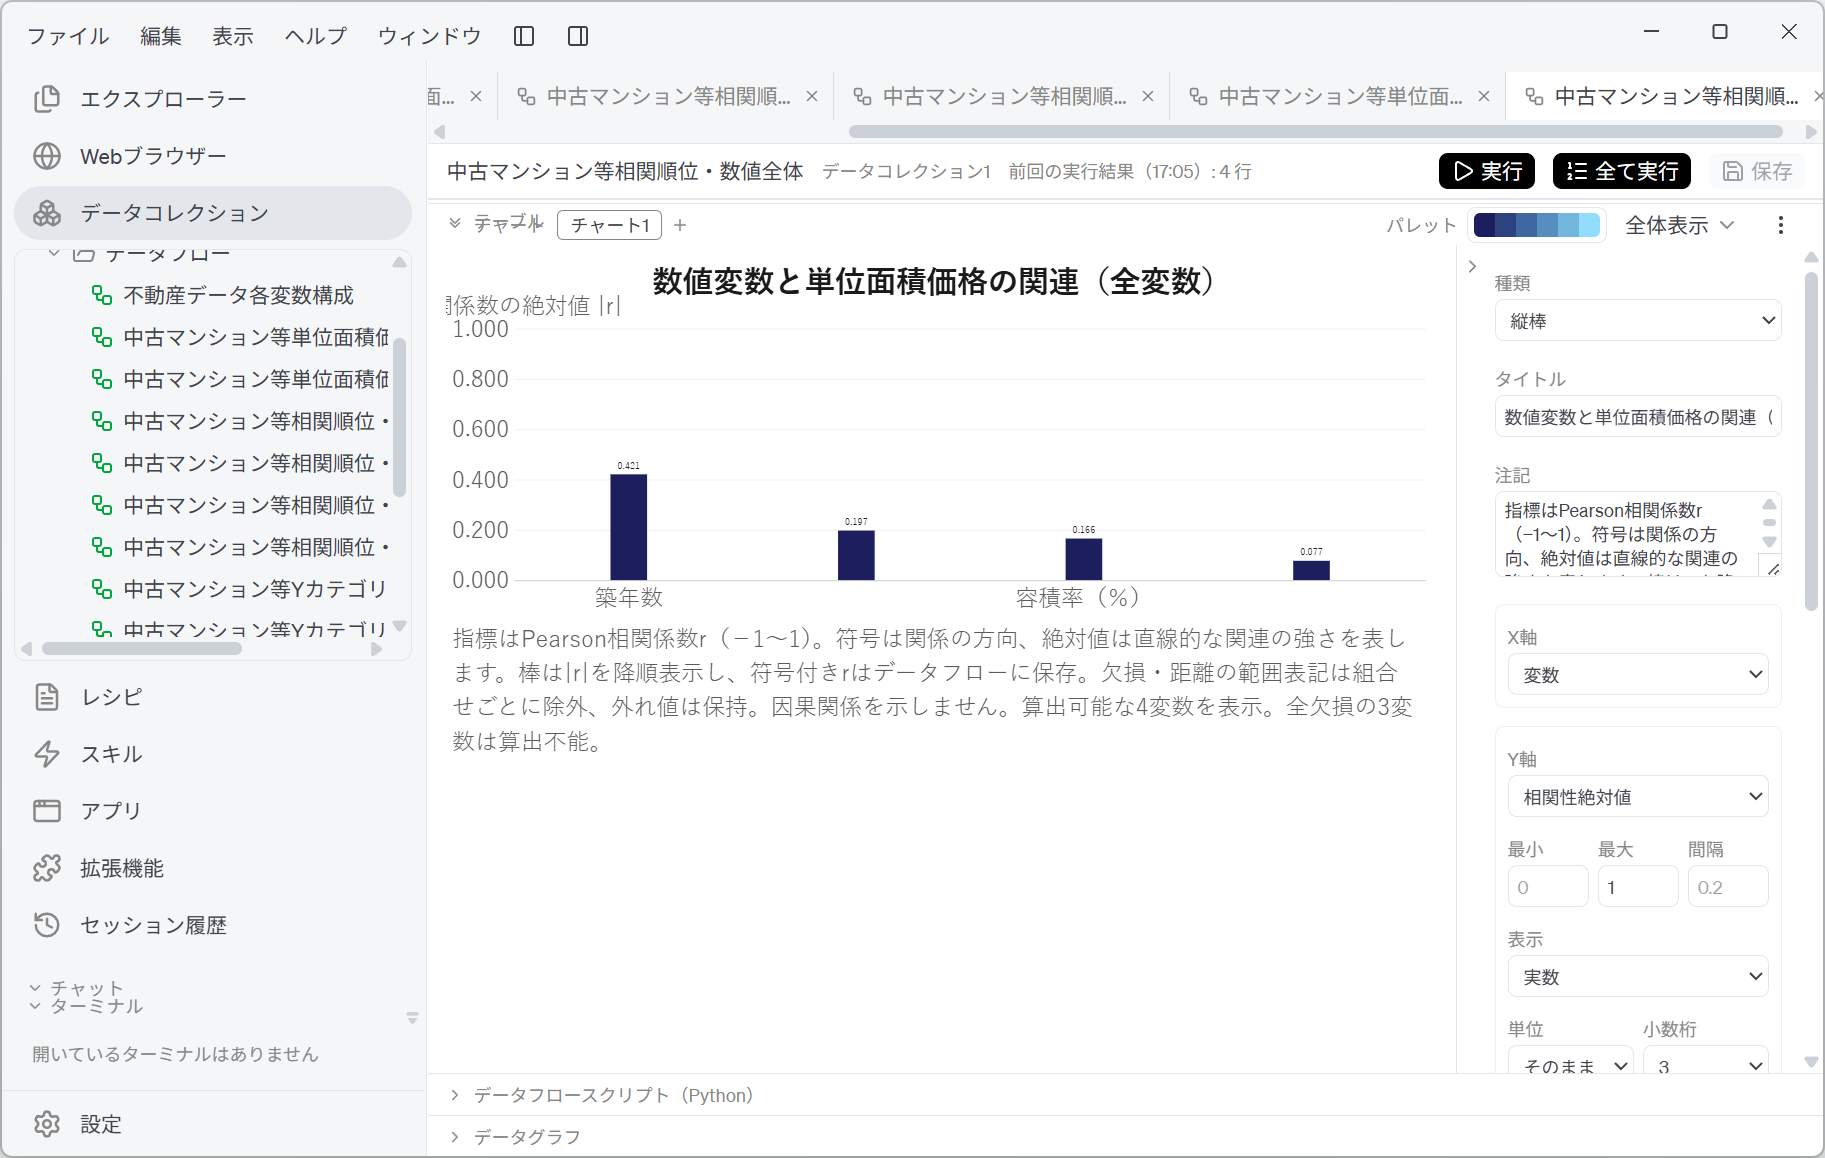
築年数 0.421 が頭ひとつ抜け、以下は最寄駅:距離 0.197、容積率 0.166、建ぺい率 0.077 と続きます。棒は4本しかありません。チャート下部のノートに、その理由を含めた前提が書かれています。
指標はPearson相関係数r(−1〜1)。符号は関係の方向、絶対値は直線的な関連の強さを表します。棒は絶対値を降順表示し、符号付きrはデータフローに保存。欠損・距離の範囲表記は組合せごとに除外、外れ値は保持。因果関係を示しません。算出可能な4変数を表示。全欠損の3変数は算出不能。
数値変数は7つありましたが、間口・延床面積・前面道路:幅員の3つは中古マンション等では全件が欠損で、算出そのものができていません。棒がないことが、値が小さいことではなくデータがないことを表しています。
- 次にカテゴリ変数です。相関比 η で降順に並んでいます。
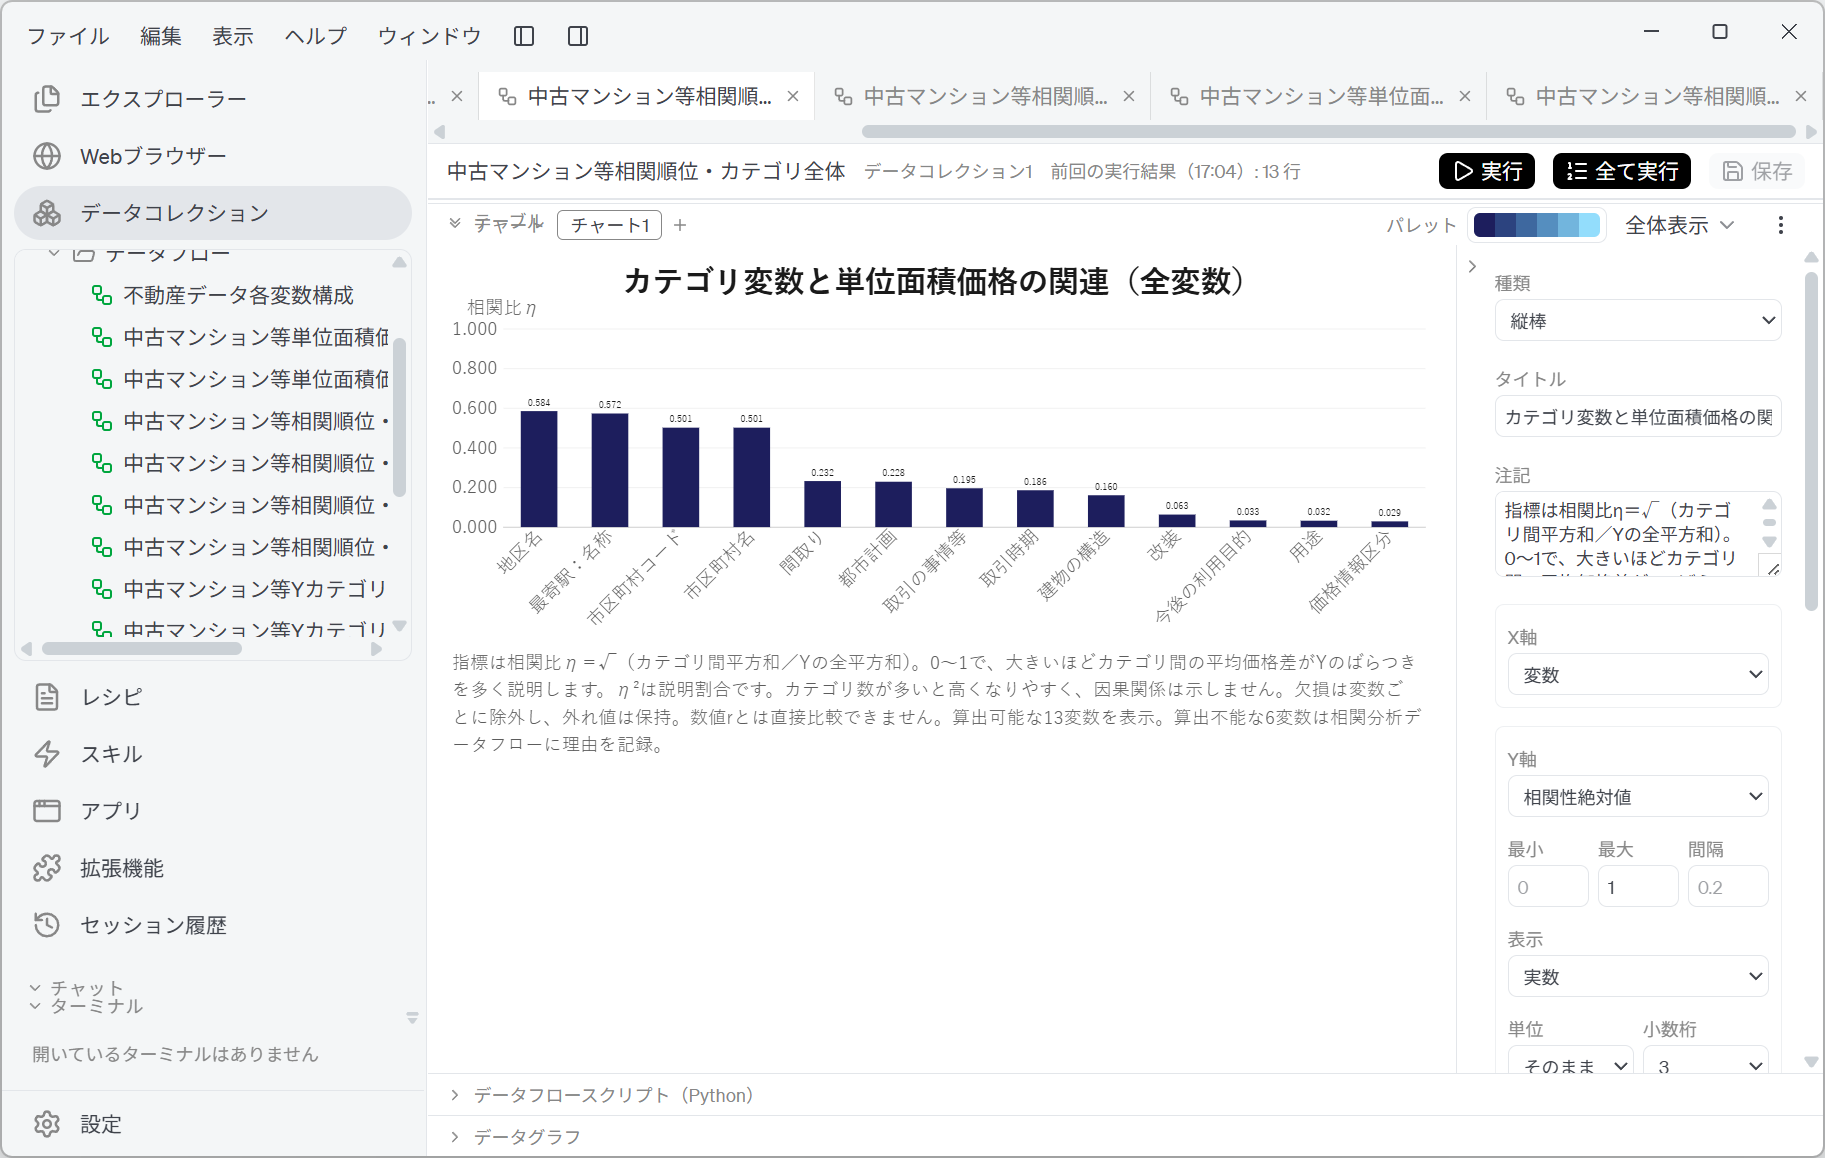
地区名 0.584、最寄駅:名称 0.572 が上位で、市区町村コードと市区町村名が 0.501 で並びます。以下、間取り 0.232、都市計画 0.228、取引の事情等 0.195、取引時期 0.186、建物の構造 0.160 と続き、改装・今後の利用目的・用途・価格情報区分は 0.063 以下です。算出できた13変数が表示され、算出不能な6変数は理由がデータフローに記録されています。
カテゴリ数が多いと高くなりやすく、因果関係は示しません。(中略)数値rとは直接比較できません。
1つめ。地区名が1位なのは、本当に地区が効いているからかもしれませんし、地区名の水準数が843もあるからかもしれません。カテゴリを細かく切れば切るほど群内のばらつきは小さくなり、η は上がります。カテゴリ変数の順位は、水準数とセットで読む必要があります。
2つめ。η と r は別の指標であり、大小を比べてはいけません。 地区名の η=0.584 と築年数の r=−0.421 を並べて「地区のほうが効いている」と読むことはできません。AI が2枚のチャートを分けて出しているのは、この2つを同じ軸に並べないためです。
カテゴリ別の平均Yを見る
順位だけでは「効いている」としか分かりません。どの値が高くてどの値が安いのかを見ます。
- 市区町村名別の平均Yです。23区すべてが表示されます。
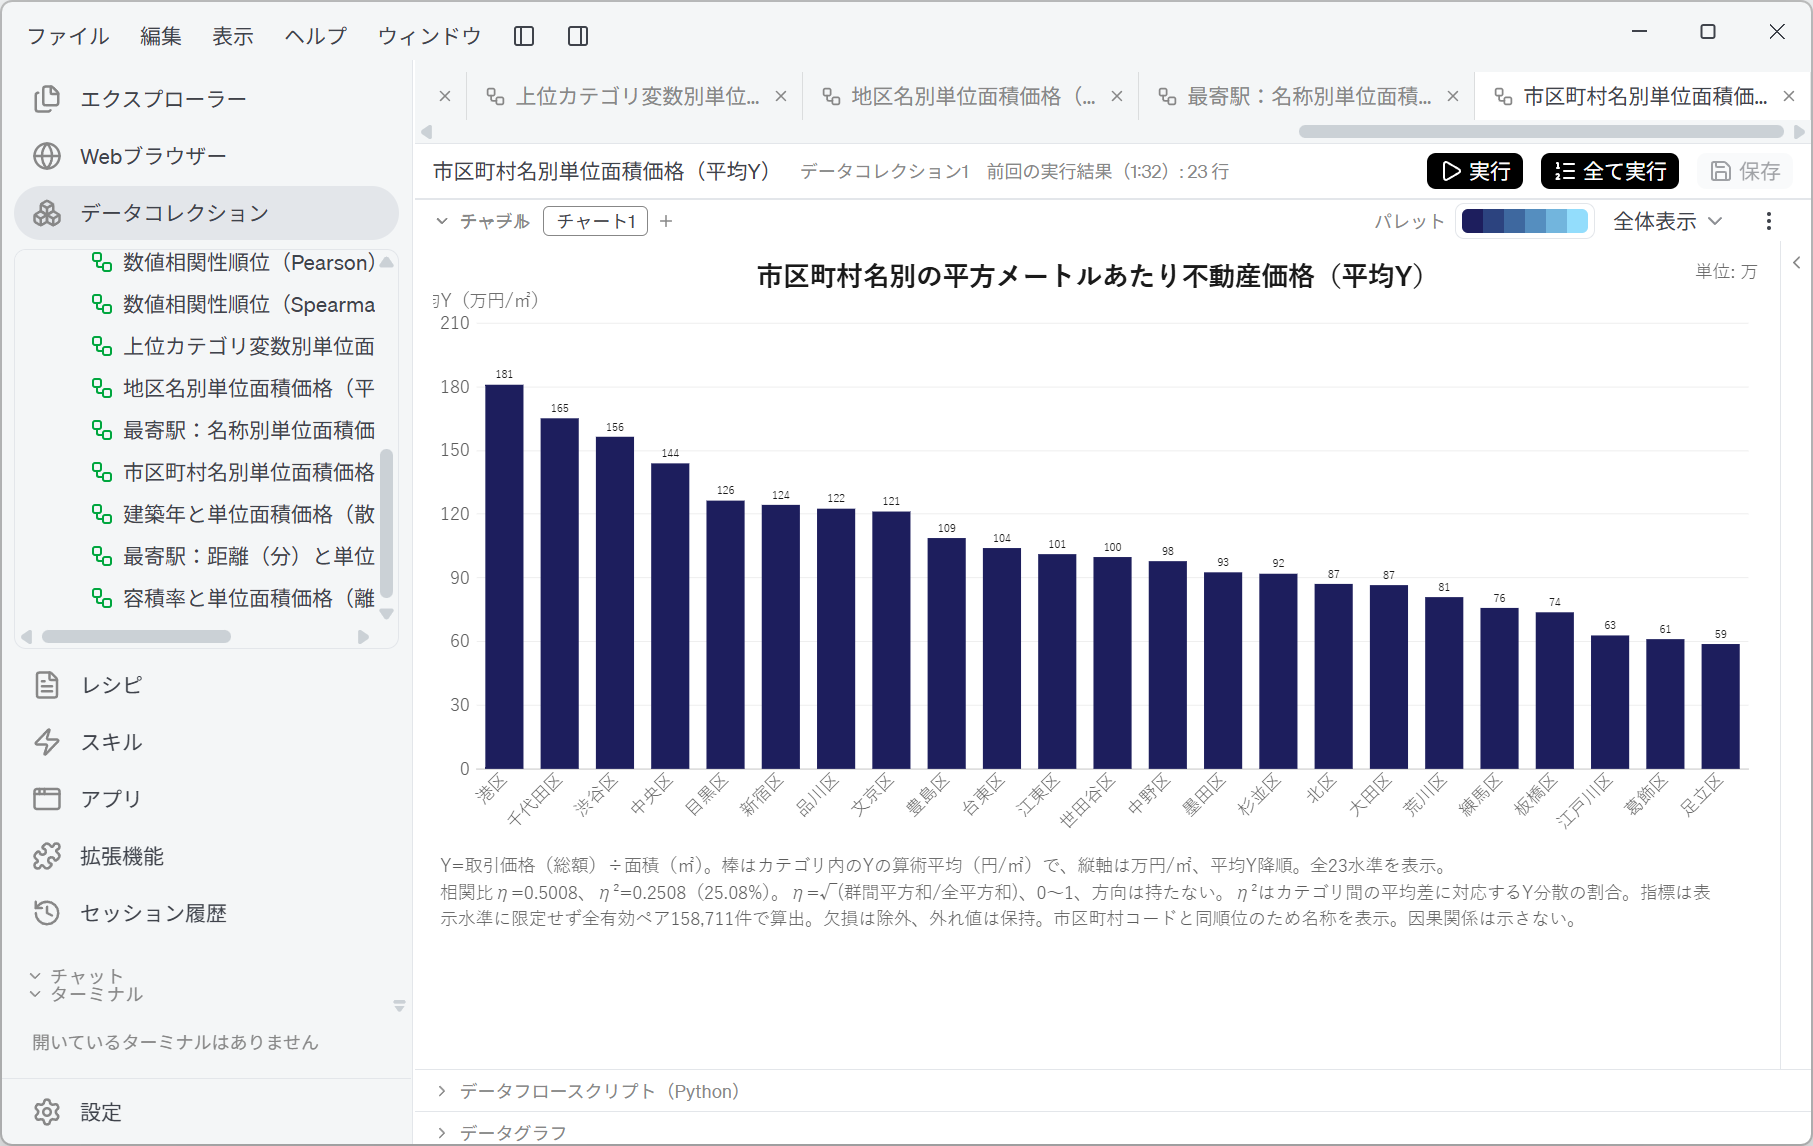
港区 181万円/㎡ を筆頭に、千代田区 165、渋谷区 156、中央区 144 と続き、最下位は足立区 59万円/㎡。最高と最低で約3倍の開きがあります。
ノートには η=0.5008、η²=0.2508(25.08%) と書かれています。η² は「カテゴリ間の平均差に対応するY分散の割合」ですから、どの区かという情報だけで、㎡単価のばらつきの約4分の1が説明できるという読み方になります。
- 地区名別の平均Yです。こちらは水準数が多いため上位30のみが表示されます。
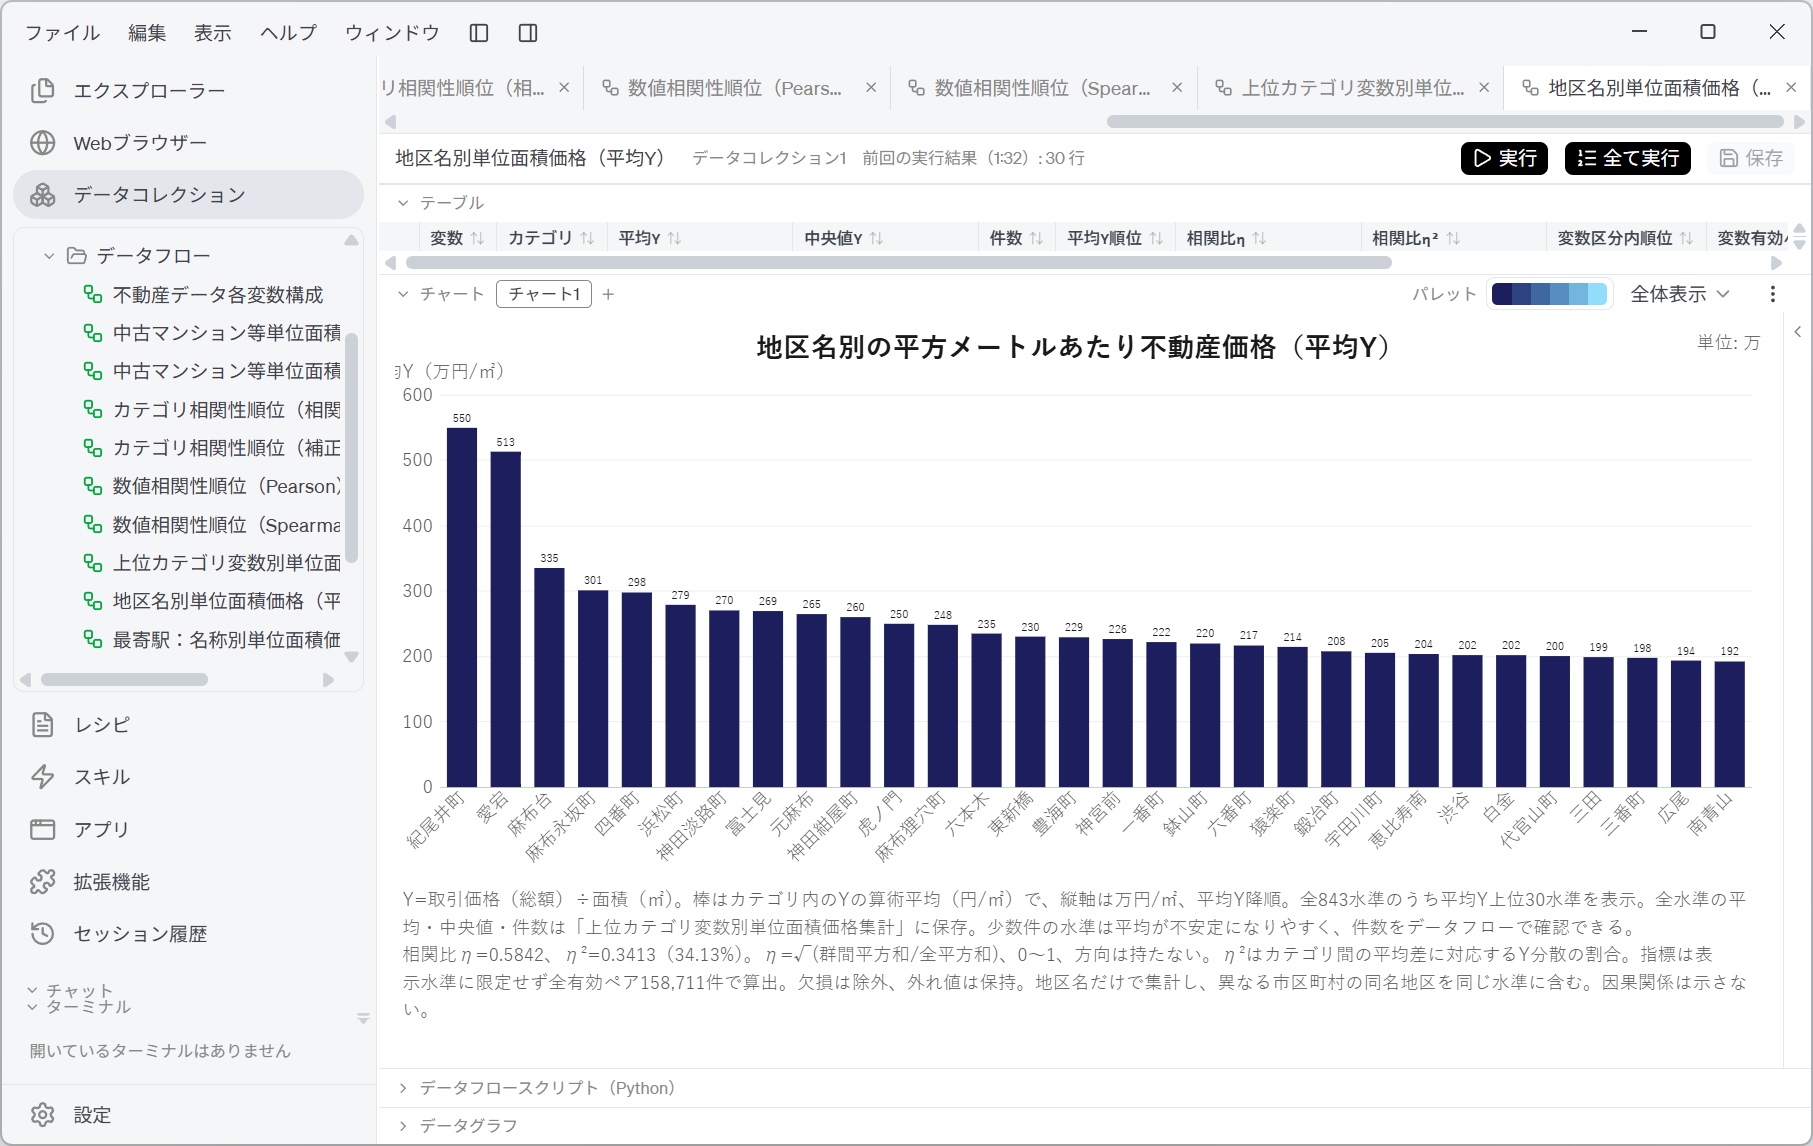
紀尾井町 550万円/㎡、愛宕 513、麻布台 335——市区町村名よりはるかに大きな開きが出ます。η²=34.13% で、市区町村名の 25.08% を上回ります。
- 全843水準のうち上位30水準のみの表示です。 残り813は画面にありません。全水準の平均・中央値・件数は別のデータフローに保存されています。
- 少数件の水準は平均が不安定です。 数件しかない地区が最上位に来ているかもしれません。件数をデータフローで確認できます。
- 地区名だけで集計しており、異なる市区町村の同名地区を同じ水準に含みます。 「本町」「中央」のような地区名は複数の区に存在します。
散布図で関係の形を確かめる
相関係数は、関係の形を1つの数字に潰したものです。同じ r=0.4 でも、きれいな直線のこともあれば、途中で折れ曲がっていることもあります。上位の数値変数については散布図で形を見ます。
- 築年数とYです。
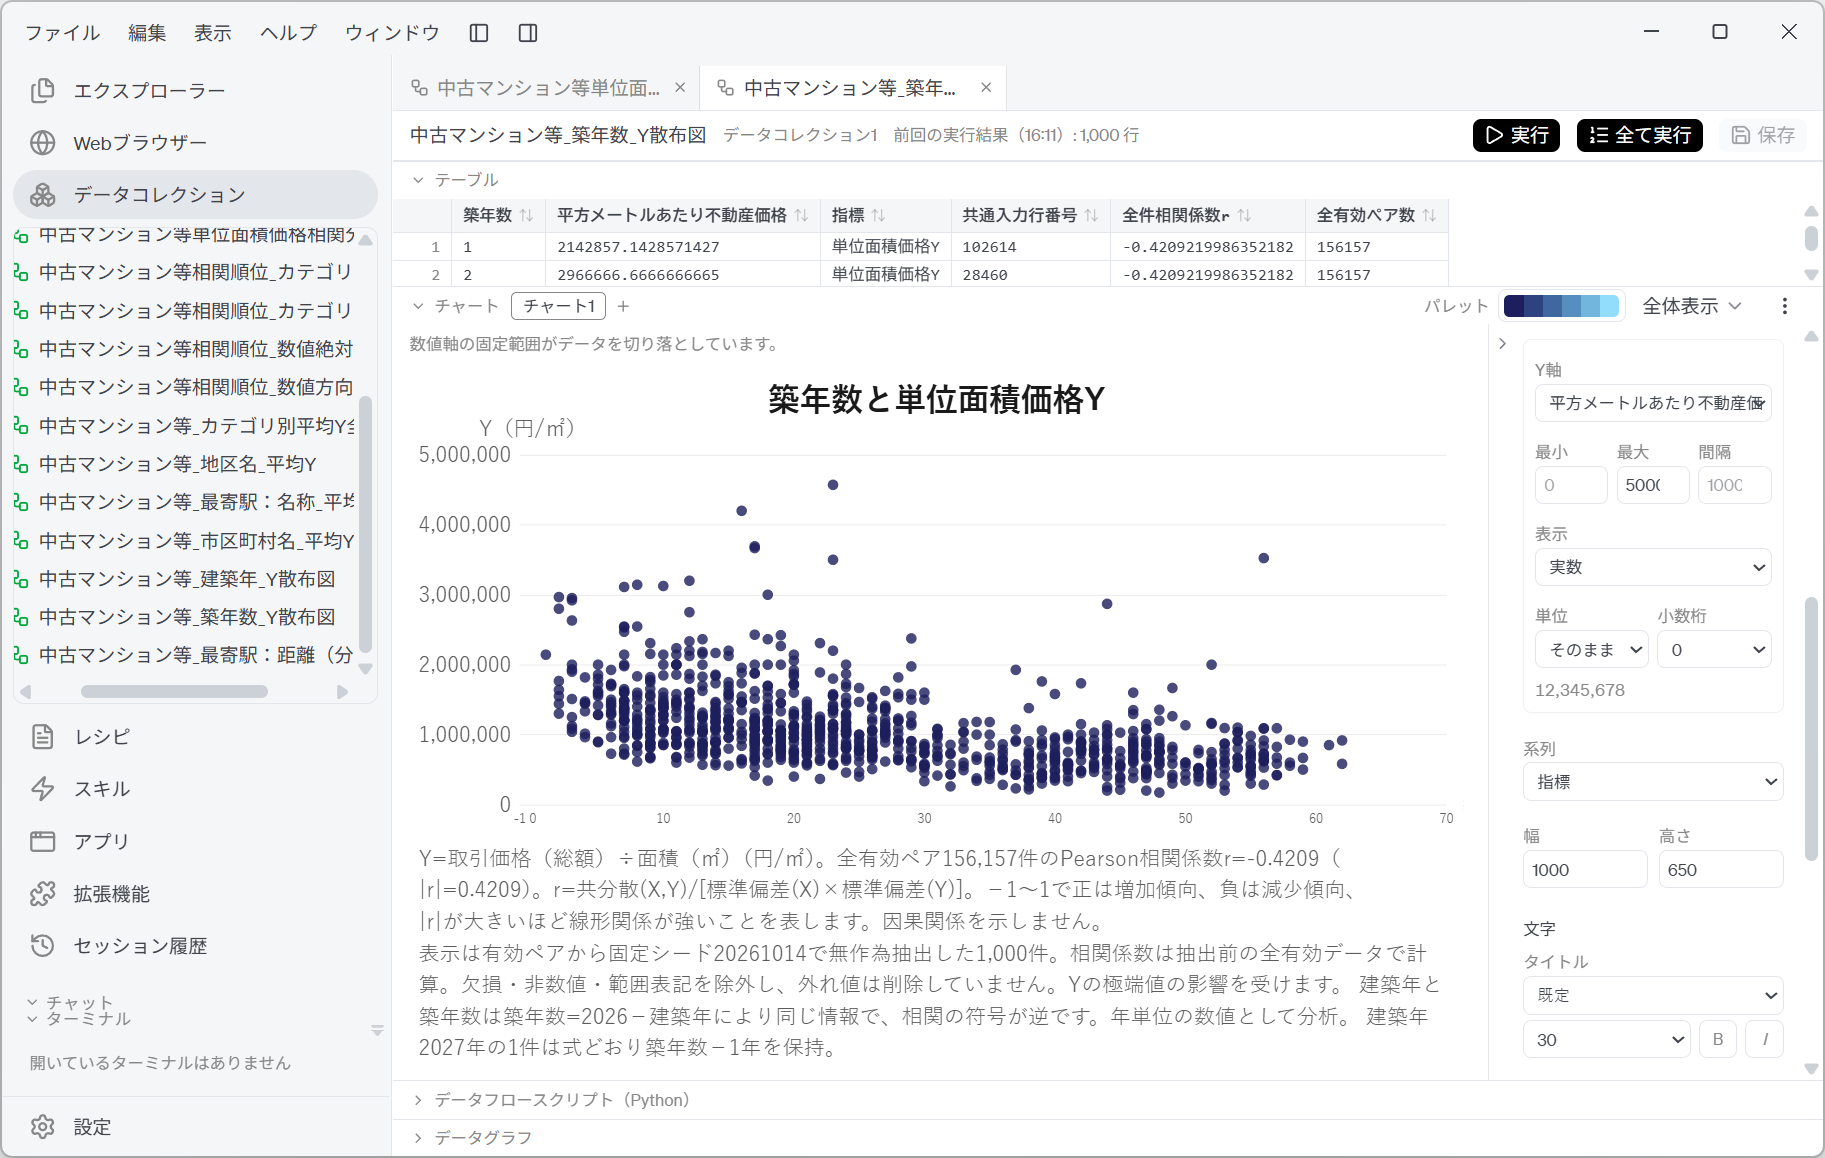
r=−0.4209(全有効ペア156,157件)。築年数が増えるほど単価が下がる傾向が、点の分布としても読み取れます。ただし築浅側のばらつきが大きく、築年数だけで価格が決まるわけではないことも同時に見えます。
表示されている点は、有効ペアから固定シード20261014で無作為抽出した1,000件です。相関係数は抽出前の全有効データで計算されているため、表示が標本でも指標は全件のものです。
- 最寄駅:距離(分)とYです。
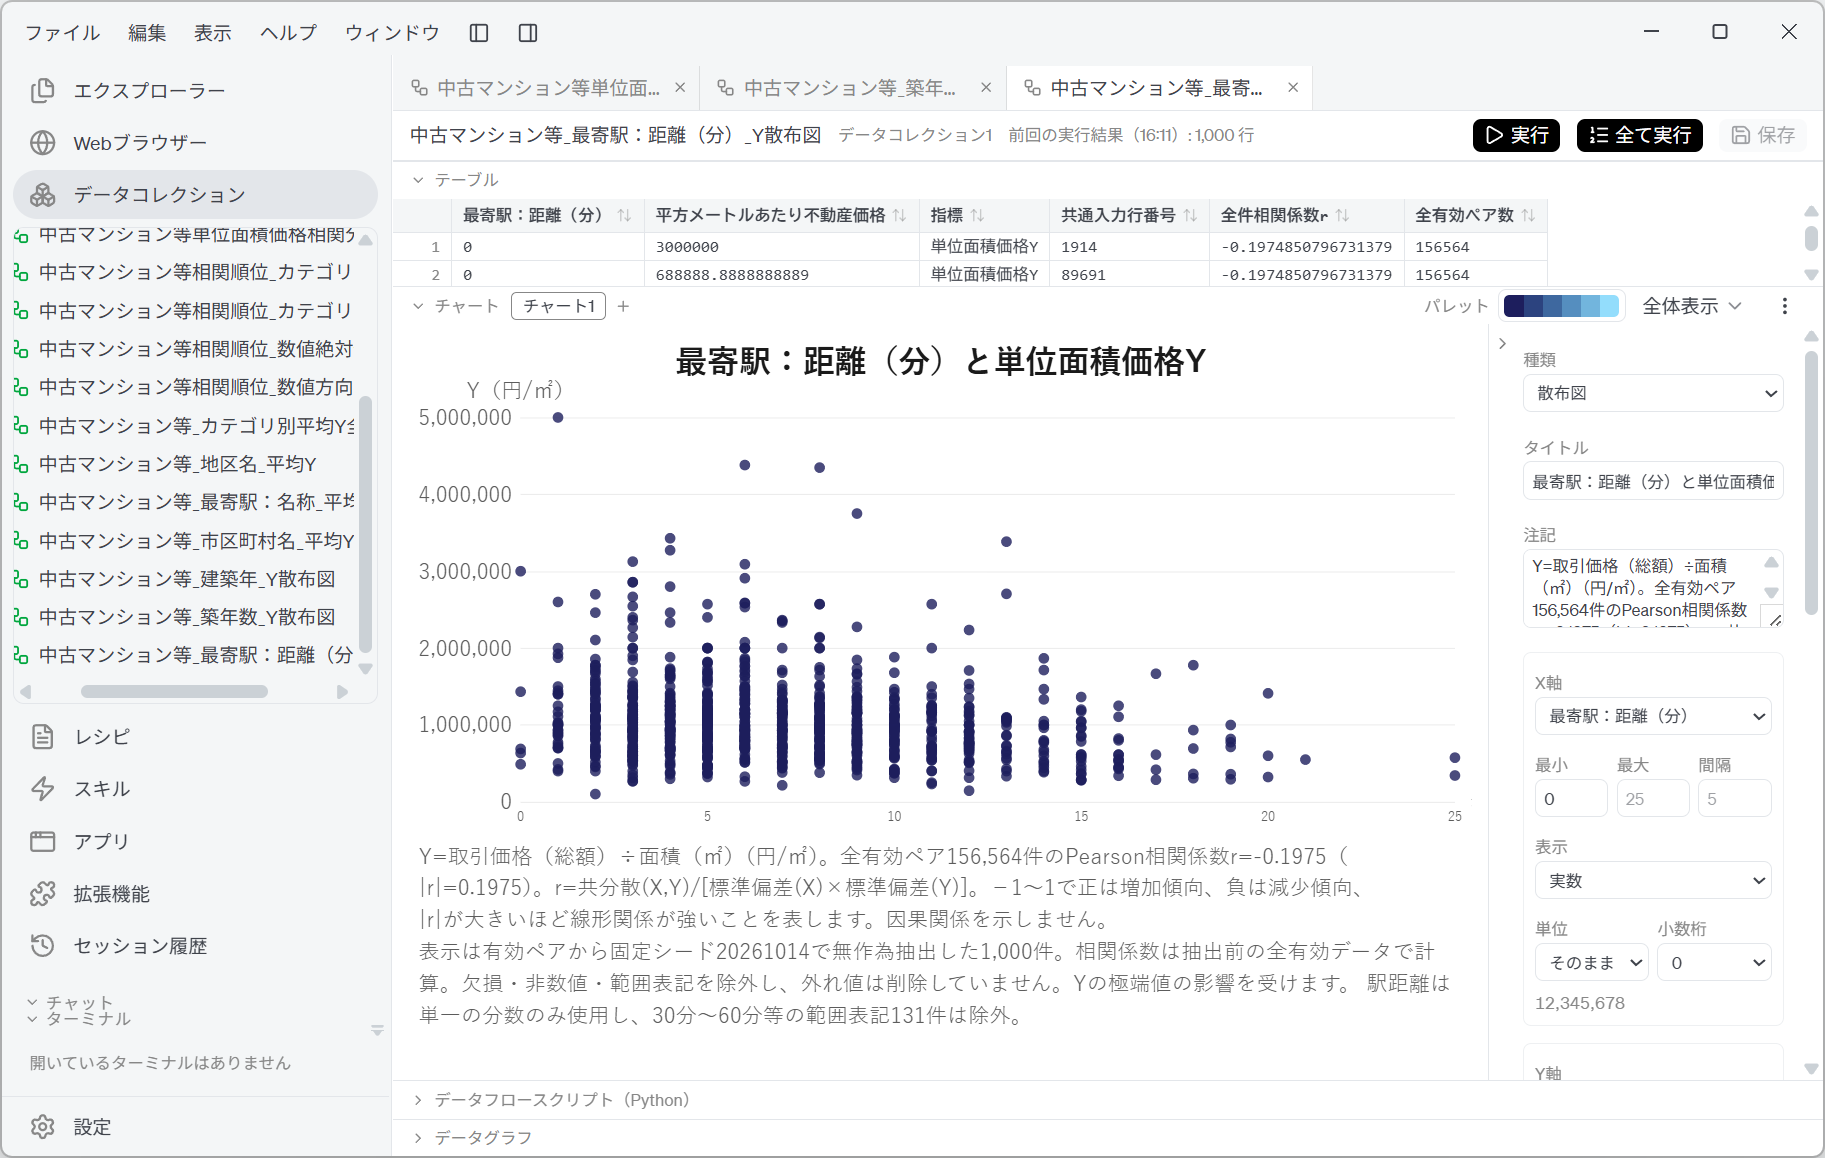
r=−0.1975(全有効ペア156,564件)。駅から遠いほど安い傾向はありますが、築年数ほど明確ではありません。
ノートに重要な但し書きがあります。
駅距離は単一の分数のみ使用し、30分〜60分等の範囲表記131件は除外。
これは概要ページで触れた表記の問題です。「30分〜60分」「1H〜1H30」を仮に45分や75分と置き換えれば点は増えますが、存在しない精度を作り出すことになります。AI は代表値を仮定せず除外し、その件数を明記しました。
どちらの散布図も、縦軸の上限で点が途切れています。チャートに 「数値軸の固定範囲がデータを切り落としています」 という通知が出ている場合、軸の上限より上に実データがあります。外れ値を含めて見るか、範囲を固定して分布の濃い部分を見るかは、目的次第で選んでください。
Human-in-the-loop のポイント
AI に任せきりにせず、次の点は人が確認してください。
-
同じ情報を二度数えていないか確認する
市区町村コードと市区町村名は同じ区分で、η も同値です。上位4つを取ったつもりで、実質3変数しか見ていないことになります。建築年と築年数も築年数=基準年−建築年で同じ情報ですが、こちらは指示の段階で建築年を除外して回避しました。 最初の実行では両方が順位表に並び、散布図まで2枚作られています。重複は指示で防ぐのが確実です。 -
指標をまたいで大小を比べない
相関比 η と Pearson の r は別の指標です。チャートのノートにも「数値 r とは直接比較できません」と書かれています。地区名 η=0.584 と築年数 r=−0.421 を並べて「地区のほうが効く」とは言えません。 -
カテゴリの順位は水準数とセットで読む
相関比 η は、水準数が多い変数ほど高く出ます。 地区名(843水準)が市区町村名(23水準)より上位なのは、地区のほうが効いているからとは限りません。水準数を揃えずに η だけで順位を付けた表は、細かく切った変数が勝つようにできています。 -
平均の裏にある件数を見る
地区名別の上位30は平均Yの降順です。数件しかない地区の平均は簡単に上下します。上位の地区について、件数をデータフローで確認してから結論に使ってください。 -
順位表そのものも、母数を揃えて読む
順位は変数ごとに使えた行数が違います。 この例では「取引の事情等」が7位(η=0.195)ですが、有効ペアは158,711件中の334件しかありません。改装 63,437件、用途 59,392件、容積率・建ぺい率 70,605件も、全体の半分以下です。母数が二桁違う変数が同じ棒グラフに並んでいることを踏まえて読んでください。 -
相関係数だけで判断せず、散布図を見る
r は関係の形を潰します。散布図を見れば、傾向の強さだけでなくばらつきの大きさも分かります。築年数の r=−0.42 は「築年数で価格が決まる」ではなく「傾向はあるが、それだけでは決まらない」と読むべきです。 -
除外された行の件数を確認する
駅距離の範囲表記131件、面積が範囲表記の行、建築年が「戦前」の行——いずれも除外されています。除外は正しい判断ですが、除外した事実は結論に添えるべき情報です。 -
因果関係と読み替えない
すべてのチャートのノートが「因果関係は示さない」と書いています。港区の単価が高いことと、港区だから高くなることは別です。相関は次に何を調べるかを決めるための道具であって、結論ではありません。
使用する LLM により、指標の選び方・変数の振り分け・チャートの構成が変わることがあります。どの変数をどちらの指標で測ったかは、データフローの「変数区分」列で必ず確認してください。
参考資料
本ページで分析しているデータは、国土交通省「不動産情報ライブラリ」から取得したものです。画面キャプチャは出所を明示した上で引用として掲載しています。AI が算出した相関指標・順位・チャートは、GotoAI が Kari の動作例として生成したものであり、国土交通省が作成・公表したものではありません。
- 資料名: 不動産情報ライブラリ「不動産価格(取引価格・成約価格)情報の検索・ダウンロード」
- 提供元: 国土交通省
- URL: https://www.reinfolib.mlit.go.jp/realEstatePrices/
- 閲覧日: 2026年10月13日
- 利用条件: 同サイトの利用規約に従います。出典:国土交通省ウェブサイト(上記 URL)。
データの性質(アンケート調査に基づくこと、取引価格が有効数字2桁に丸められていること、2つの出所が混在すること)については、概要の「扱うデータの性質」を参照してください。
- 本サイトで引用した外部の情報は、Kari の利用例を説明するためのものです。それらの情報の正確性や最新性について、本サイトは保証しません。引用元の内容は予告なく変更・削除されることがあります。
- 本サイトで示した AI の出力は、記載の検証環境で実際に得られたものです。ただし、その出力の正確性や有用性について、本サイトは保証しません。AI の出力は、使用する LLM や設定、実行のたびに変わることがあります。
- 本ページの相関指標は、記載の前提(中古マンション等への絞り込み、外れ値の保持、欠損のペアごと除外)のもとで算出されたものです。前提が変われば値も変わります。
- 相関は因果関係を示しません。 本ページのいかなる数値も、価格の決定要因を特定したものではありません。
- 画面キャプチャは、掲載時点のバージョンの Kari で取得したものです。お使いのバージョンでは表示が異なる場合があります。
- 本ページで扱うのは実際の不動産取引価格のデータです。購入や投資の判断に用いる場合は、必ず元データと照合してください。
- 引用元の各機関・団体は、本サイトおよび Kari と提携・推奨関係にはありません。